一克土里住着几万个微生物,肉眼看不见,却左右着作物长得好不好。连续种了几年忽然死棵、施肥越多反而越僵,问题常常出在这些看不见的住户身上。测序给了把它们看清楚的机会,可拿到报告不等于拿到答案——采样规不规范、数据怎么质控、群落差异能不能当结论,每一步都影响最后的判断。华昇金玛植保系统课第075课从采样送检一路讲到田间决策:先弄清楚测序能回答什么、不能回答什么,再谈怎么把数据用回地里。
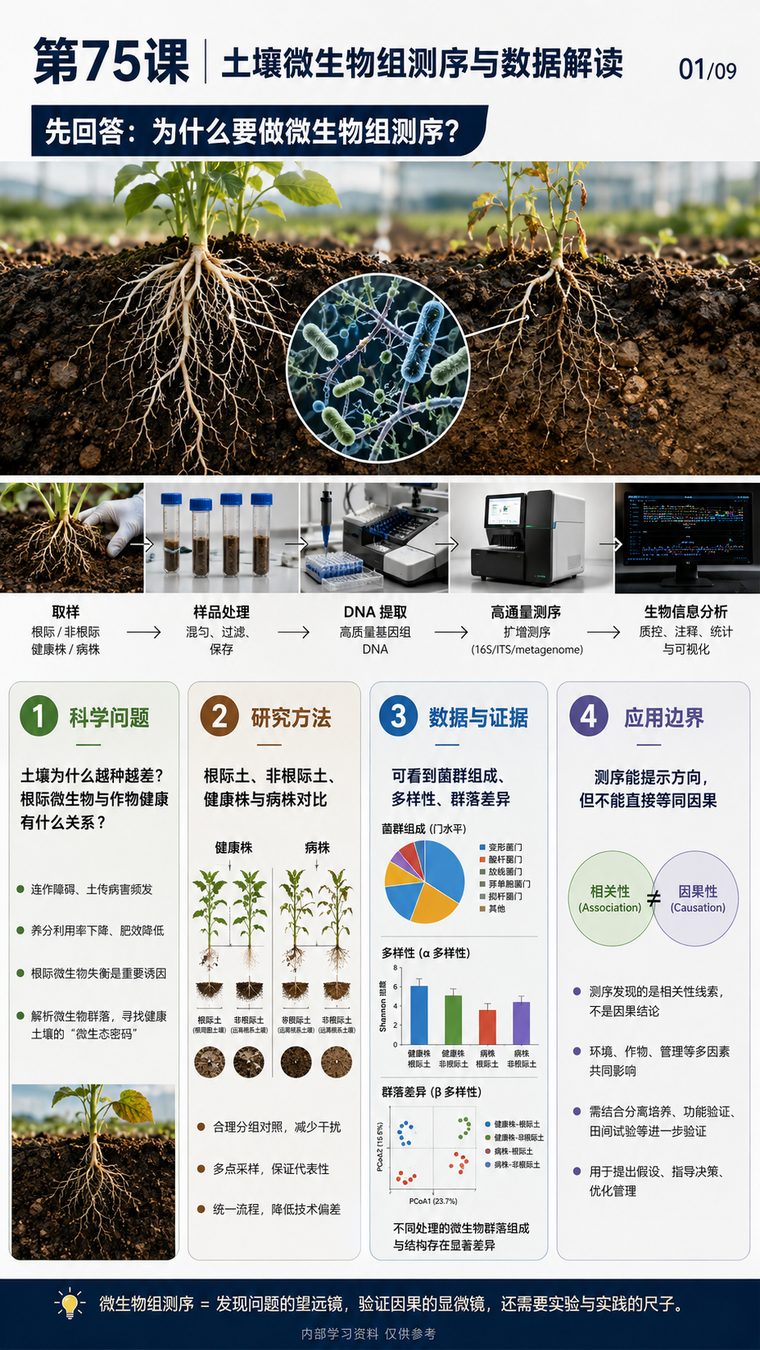 01/09 丨微生物组测序的价值与定位
土壤里的微生物数量最多、种类最杂,却最难直接观察。健康植株和病株的根际土放在一起对照,两边的群落结构并不一样:一边是有益菌活跃、多样性高,另一边常见病原相关类群富集、多样性下降。课程页用健康株与病株的根际对照图,加一张显微视窗,把这种看不见的差别摆到台面上。它要回答的是作物长势与土壤状态背后的生物原因,而不是单纯给某块地贴标签。
整套流程分五步:取样、样品处理、DNA 提取、高通量测序、生信分析。页面把研究拆成四栏——科学问题问群落结构和功能是什么、与作物表现有什么关系;研究方法解决怎么采样、怎么测、怎么分析;数据与证据关心数据质量与结论可信度;应用边界提醒测序能给出线索与假设,不能单独下因果结论。四栏分开看,才不至于拿一个群落的差异去解释所有田间现象。定位找准,后面的分析才不跑偏。
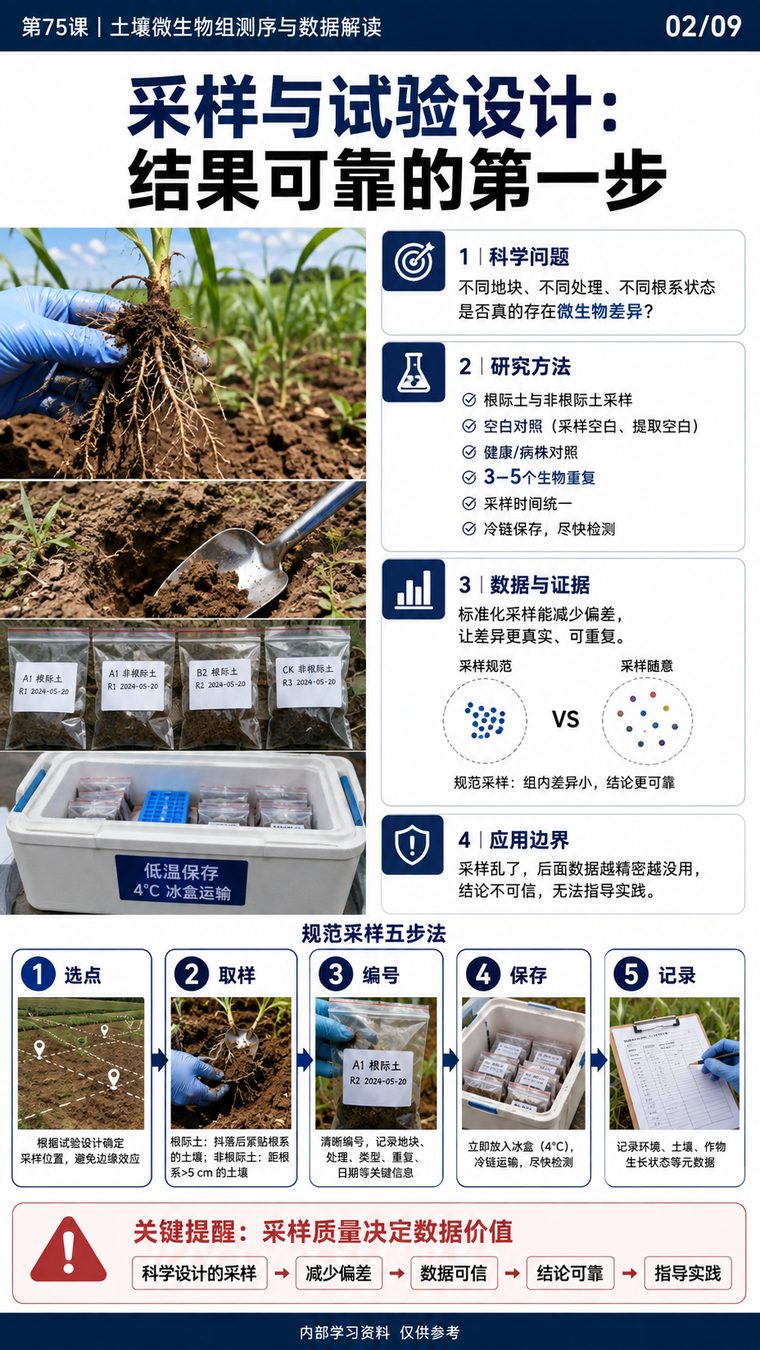 02/09 丨根际与非根际土的采样设计
根际土指的是抖落大块土壤后仍紧贴根系的那层土,微生物受根系分泌物影响最强;非根际土则取距根系五厘米以上的土,用来做背景对照。两者能不能分清,直接决定后续结论反映的是根系效应,还是地块本身的差异。采样还要设三到五个生物重复,并配采样空白与提取空白,用来扣除采样和实验环节混进来的污染。冷链保存控制在四摄氏度左右,尽快送检,避免菌群在运输途中发生变化。
规范采样按五步走:选点、取样、编号、保存、送检。选点要避开施肥沟、地头和田埂边缘这些容易失真的位置;取样时用土钻或铲子分层取,编号要让每份样品唯一可追溯;保存要冷藏避光防挤压;送检连同采样记录一起交出去。记录里写清经纬度、时间、土样类型、深度和地块管理情况,后面解读数据时,这些信息往往比一堆测序参数更管用。记录跟着样品走,解读才落得下来。
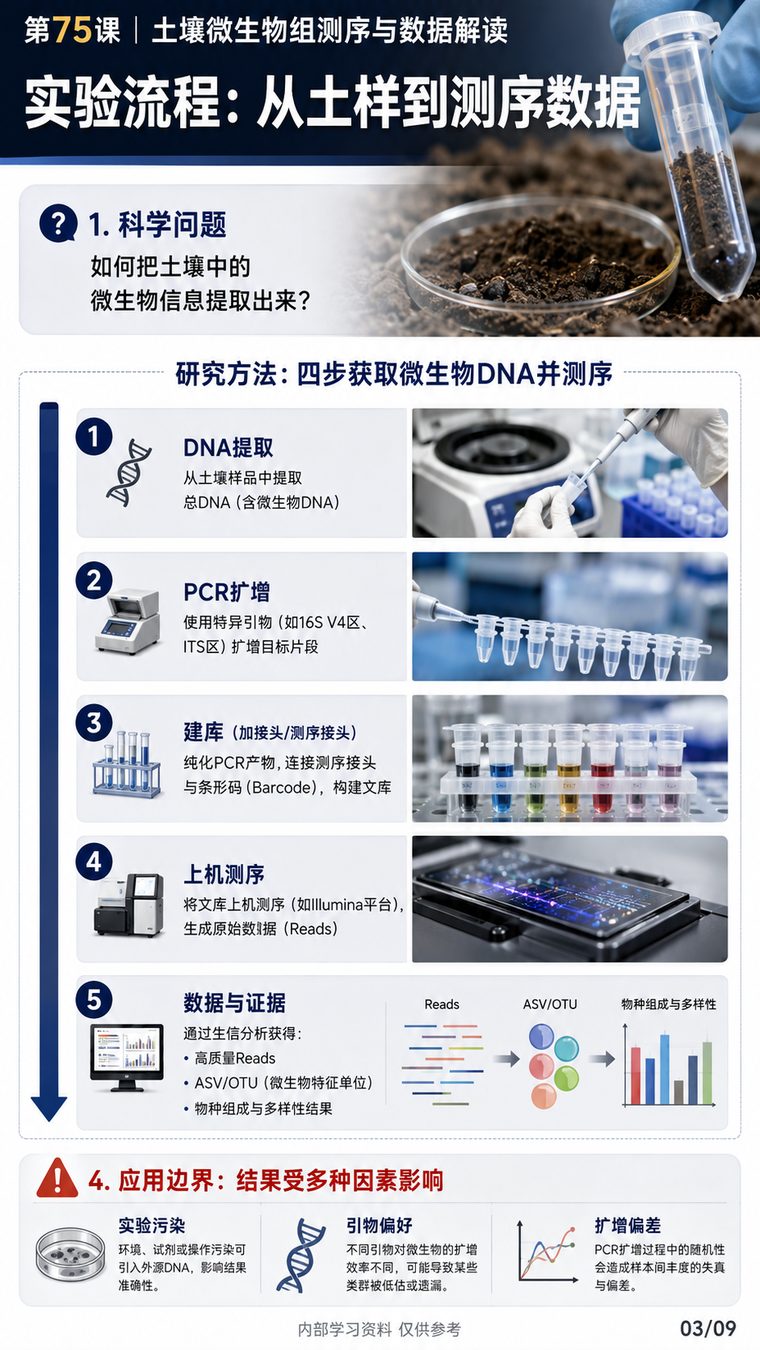 03/09 丨从土样到测序数据的五步流程
土样进实验室后,先做 DNA 提取与质检,提取质量不过关,后面所有分析都建在沙子上;接着做 PCR 扩增与建库,常见做法是扩增 16S rRNA 基因的高变区;然后上机测序,得到原始 Reads;再进入数据产出环节,把 Reads 聚类成 ASV 或 OTU,得到物种组成与多样性指标;最后做生信分析,比较组间差异、预测群落功能。五步之间有依赖,前一步的偏差会在后一步被放大。
这套流程也有它的边界。实验过程中可能有污染混进来,引物对某些类群存在偏好,扩增本身带偏差,不同批次的文库还有技术差异。这些都会让结果偏离真实群落,需要在设计阶段用空白对照和重复来约束,在分析阶段用质控和统计去降低影响。把测序当成一把有刻度的尺子,而不是一台直接给答案的仪器,判断会更稳。把这几步的边界记牢,再看报告里的数字,就不会被一张漂亮的图带偏方向,提出假设时也更有底气。
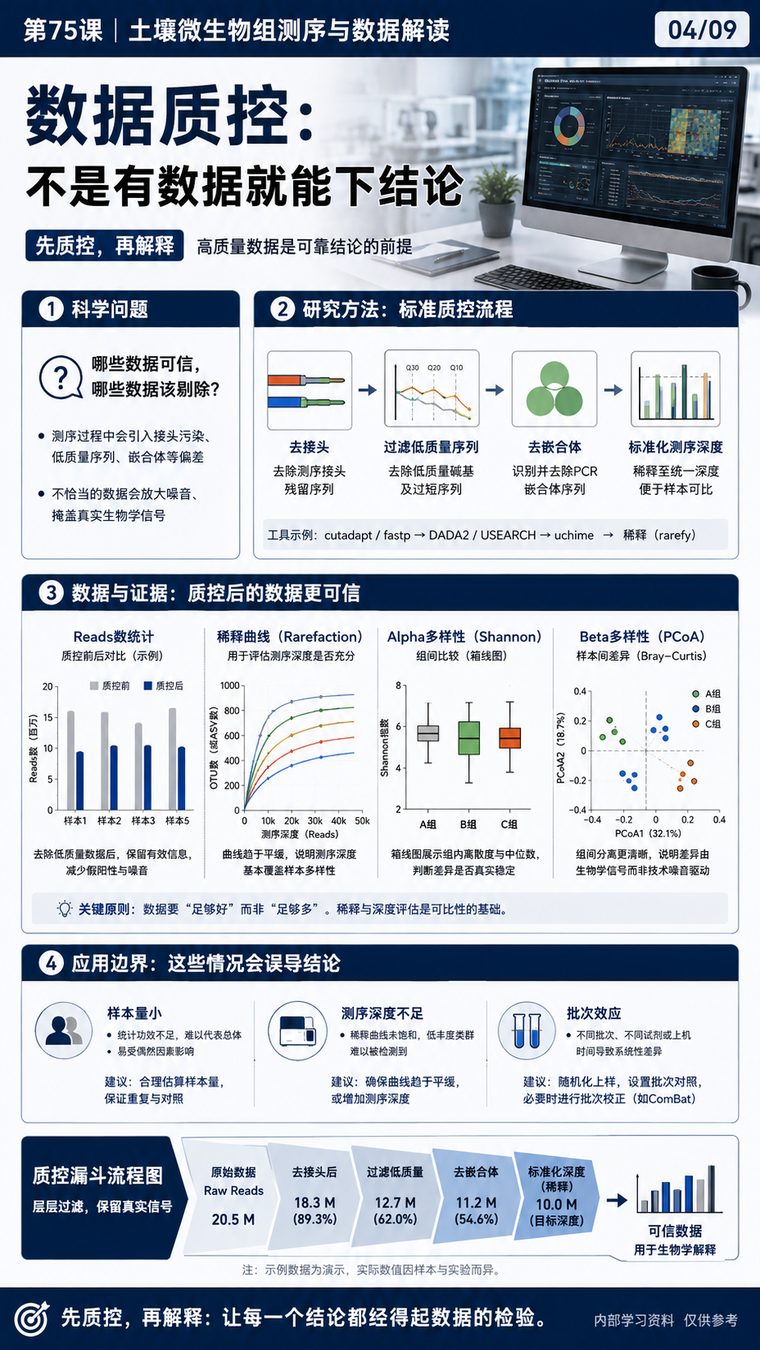 04/09 丨测序数据的质控与多样性
原始下机数据不能直接拿来分析。要先去掉测序接头,按 Q20、Q30 这类质量值过滤低质量碱基,剔除嵌合体序列,再做标准化处理,让各组样本的 Reads 数可比。页面给了一组对照:质控前每组约一千六百万到一千七百万条 Reads,质控后降到约九百五十万到一千万条,损耗约三成到四成。这不是浪费,而是把噪声挡在门外。
质控之后看两个层面。一个层面是测序深度够不够,用稀释曲线判断,曲线趋于平台说明测到的种类接近饱和;另一个层面是群落多样性,用 Shannon 箱线图比较各组的中位数与离散度。再往上是 Beta 多样性,用 PCoA 把样本分布画在二维平面上,组内样本越聚拢、组间越分开,说明分组差异越明确。质控漏斗加这三张图,构成判断数据能不能用的第一道门槛。把质控结果和数据量对照着看,才知道手里的结论有多大底气,测序经费是不是花在了刀刃上,一目了然。
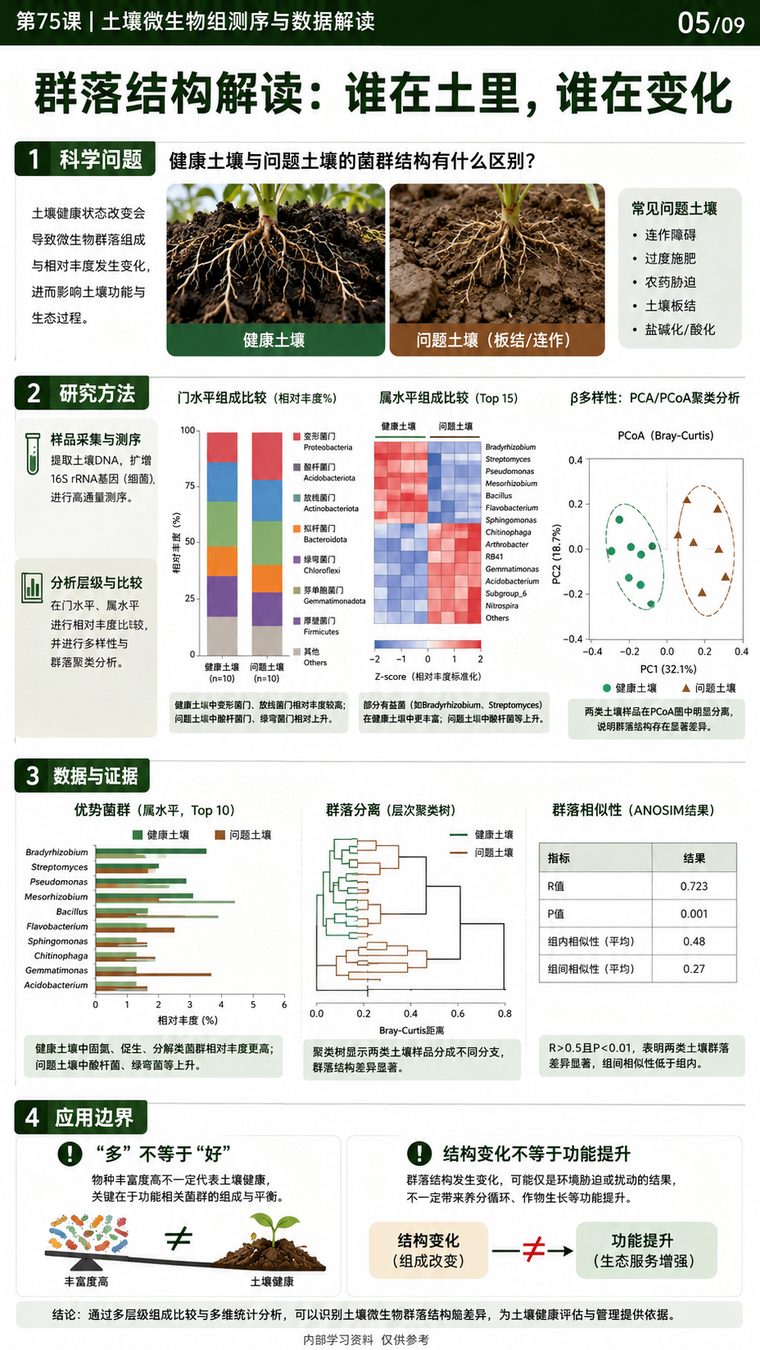 05/09 丨群落结构柱状图与热图解读
门水平堆叠柱状图回答"谁多谁少"。页面给出八个主要门类:变形菌门、酸杆菌门、放线菌门、拟杆菌门、绿弯菌门、芽单胞菌门、厚壁菌门,其余归入其他。想看得更细,就上属水平 Top15 热图,用 Z-score 标准化后,红色代表相对丰度高、绿色代表低,组间成块的颜色差异就是线索。柱状图看整体格局,热图看具体类群,两者配合才能定位到变化的属。
PCoA 把样本按群落相似度铺到平面上。页面案例中第一主轴解释百分之三十二点一的变化,第二主轴解释百分之十八点七,ANOSIM 检验给出 R 等于零点七二三、P 等于零点零零一,说明组间差异真实存在;组内相似性约零点四八、组间约零点二七,一高一低正说明分组有意义。测序常用来分析连作障碍、过度施肥、农药胁迫、土壤板结、盐碱化与酸化这几类土壤问题,先在图上看到差异,再去追问原因。图上先找差异,管理上再找办法,两件事分头做。
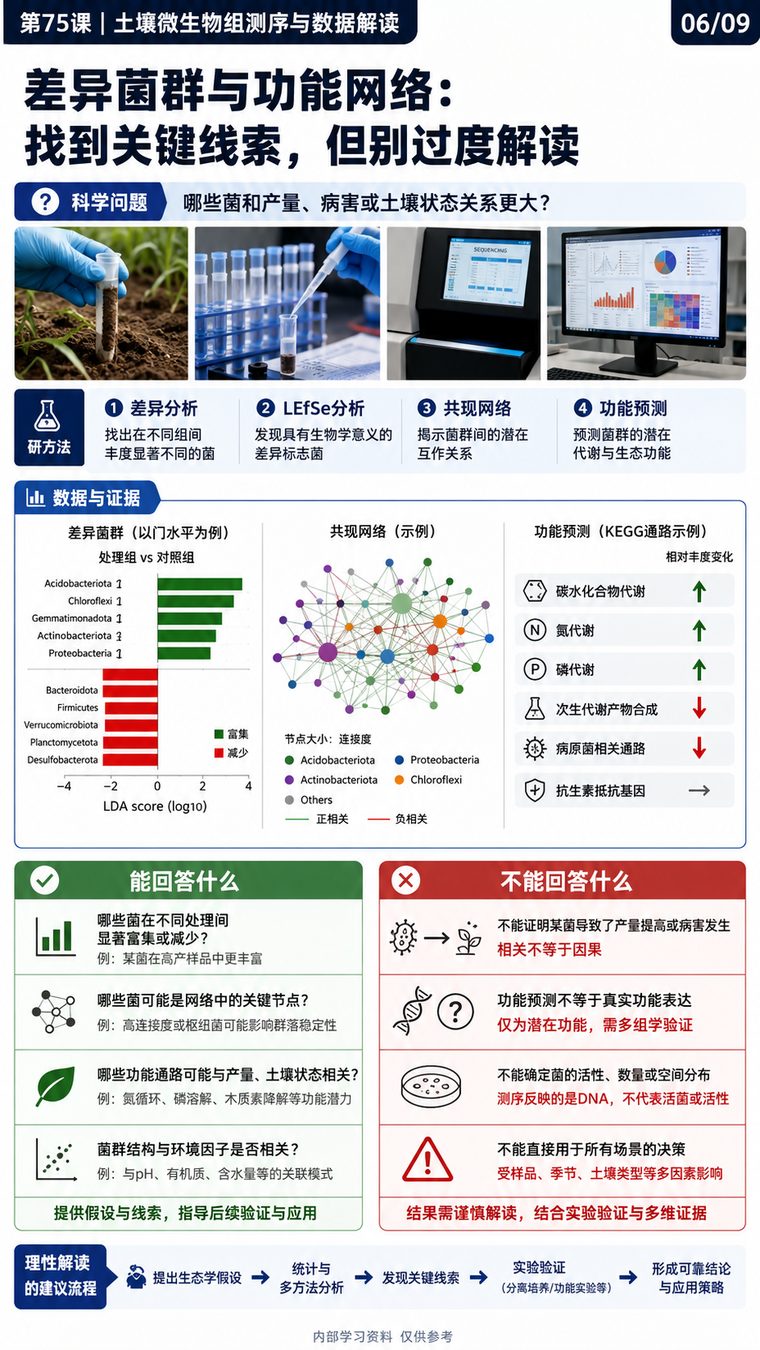 06/09 丨差异菌群与共现网络分析
找出组间差异的类群,常用差异分析和 LEfSe。前者做组间统计比较,后者在门到属的各层级上挑出区分两组的标志类群,页面用 LDA score 的对数值展示哪些门类在一端富集、哪些在另一端减少。差异类群是切入点,列出一串名字并不等于搞清了机制,还要看它们彼此怎么关联、在群落里处在什么位置。
共现网络用节点和连线表示类群之间的关系,节点大小代表连接度,绿线表示正相关、红线表示负相关,连接度高的类群往往处在网络的关键位置,值得重点关注。有了网络,还可以做功能预测,推断群落可能具备的代谢能力。留意页面给出的提醒:丰度差异和网络位置都属于相关性证据,菌群的功能要靠培养、接种或田间试验去验证,别把一张网络图当成定论。网络里位置再关键的类群,也只是提示你先去查它;查过、试过、在田里见过效果,才能当真。
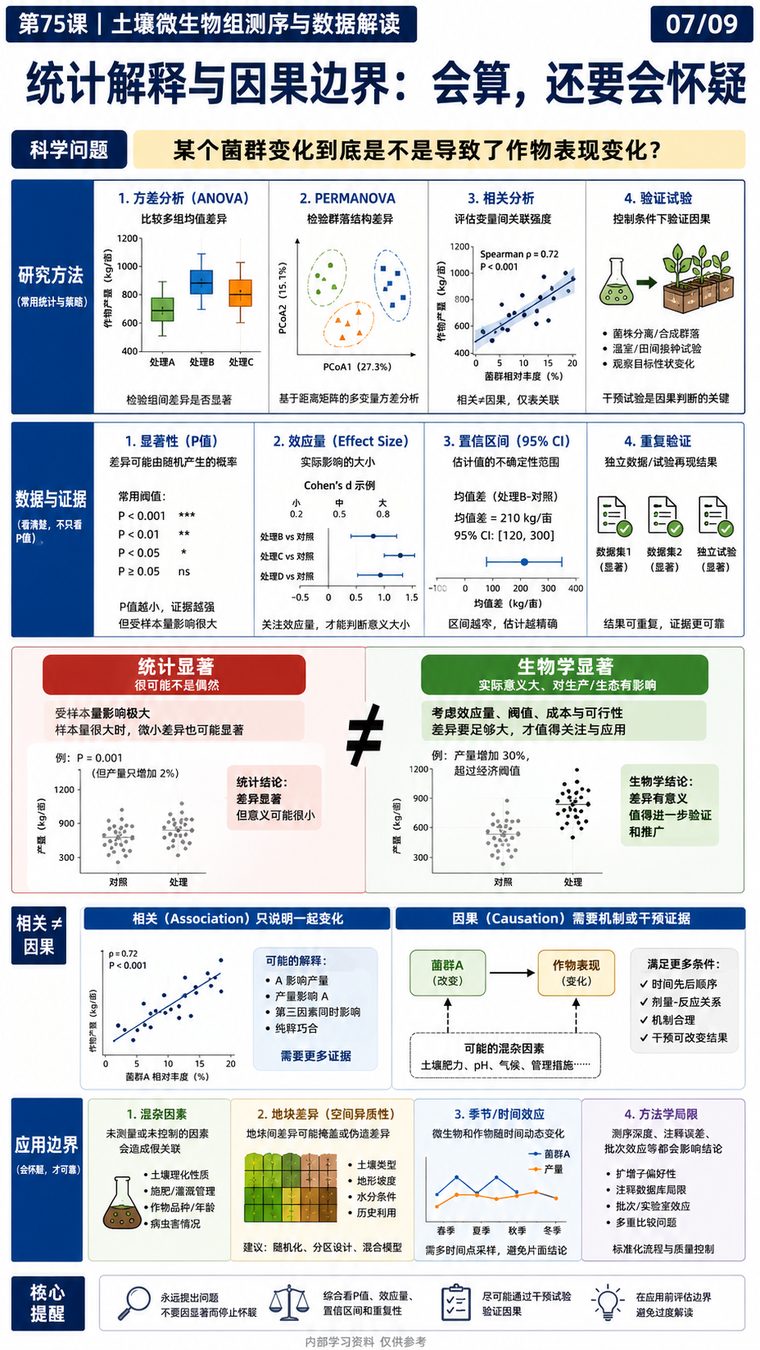 07/09 丨统计显著性、效应量与因果边界
看统计结果先认两类信息。一类是检验方法:比较三组以上用方差分析,比较群落组成用 PERMANOVA,看两批数据是否同步变化用 Spearman 相关,页面案例里相关系数为零点七二、P 小于零点零零一。另一类是显著性标记:P 小于零点零零一标三颗星,小于零点零一标两颗,小于零点零五标一颗,不小于零点零五标 ns。P 值说明差异不太可能是偶然,但它的大小并不等于效果大小。
所以还要看效应量。Cohen's d 里,零点二算小效应、零点五算中等、零点八算大效应;再配合置信区间判断估计有多稳,页面案例中产量均值差的置信区间是每亩一百二十到三百公斤、点估计为二百一十公斤,区间不跨越零,结论才站得住。统计显著和实际意义是两回事,页面那个大大的不等号提醒的正是这层区别:能跑出显著性,不代表这个变化值得你改掉整套管理办法。把效应量、置信区间一起看,判断才不虚。
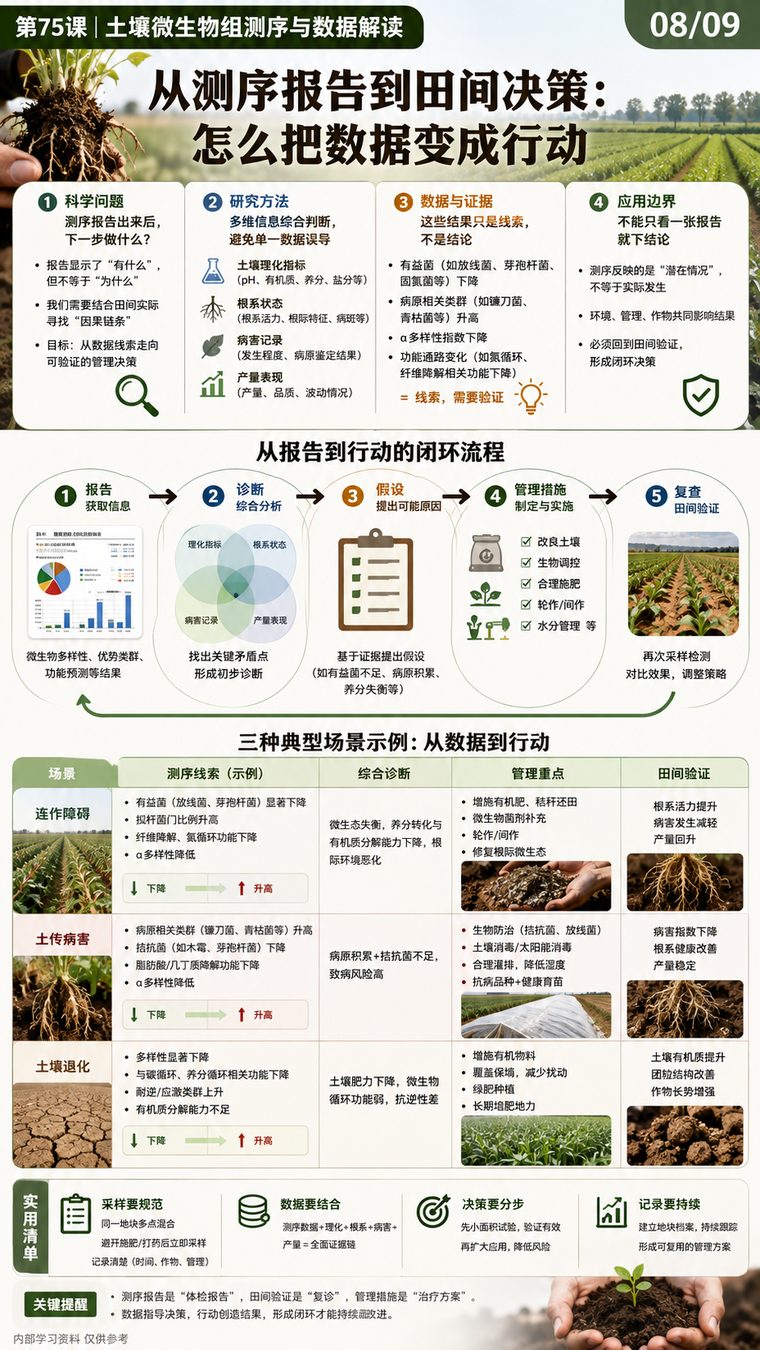 08/09 丨从测序报告到田间管理决策
拿到测序报告先别急着照抄结论。闭环是这样走的:获取报告,把多样性与优势类群、差异类群信息综合成诊断,据此提出假设,制定并实施管理措施,最后回到田间复查验证,用效果反过来修正假设。页面把三种典型场景列成表格——连作障碍、土传病害、土壤退化,各自对应测序线索、综合诊断、管理重点和田间验证方式。
以连作障碍为例,常见线索是多样性下降、有益菌减少、病原相关类群升高,对应的管理重点是有机质补充、合理轮作、减少单一连作,必要时补充功能微生物;验证则看下一季的根系健康与产量。华昇金玛三结义微生物菌剂属复合微生物菌群产品,主打防病促生,按冲施或灌根每亩每次一到两升使用,注意避开强光高温时段。用它配合测序结论调理根区菌群,方向是对的,但仍要留出对照区观察效果。对照区的数据,是最有说服力的验证。
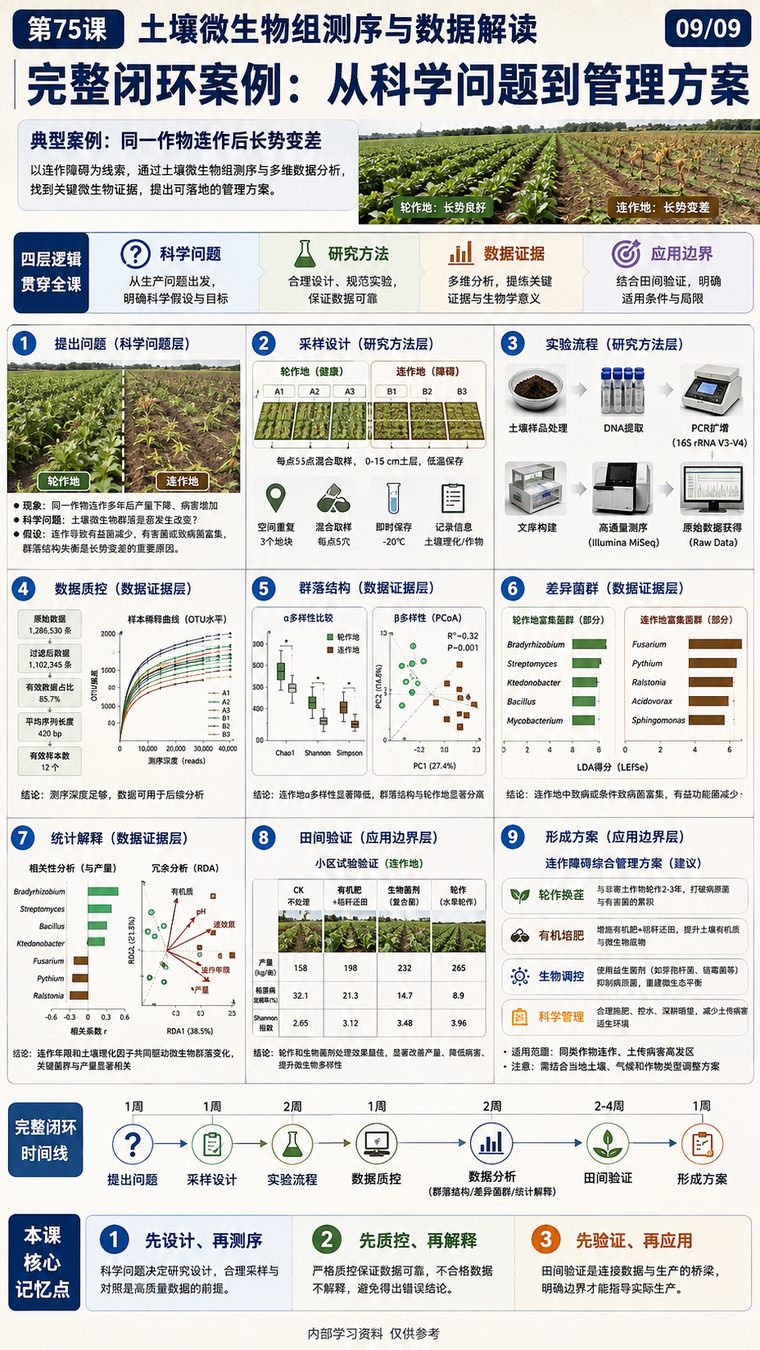 09/09 丨连作障碍闭环案例的完整解读
案例拿同一块地的轮作区与连作区做对照,长势照片先摆出差别:轮作区根系白壮,连作区发黄瘦弱。接着进入数据层,Alpha 多样性用 Chao1、Shannon、Simpson 三张箱线图比较,连作区的多样性普遍更低;Beta 多样性用 PCoA 呈现,第一主轴解释百分之二十七点四、第二主轴解释百分之十点六,R² 约零点三二、P 等于零点零零一,说明两组群落确实分开。
再看到具体的类群,轮作区富集了慢生根瘤菌这类与固氮、促生相关的菌属。案例把科学问题、研究方法、数据与证据、应用边界四个层面收进一张九宫格:从想知道连作为什么减产,到怎么采样怎么测,到数据说明了什么,再到结论能用到哪些地块。所谓把数据用起来,就是沿这条路径走完,把每一项证据放回它该待的位置,而不是停在报告的第一页。四层信息接起来,报告才真正变成能落地的管理依据,下一次采样也才知道该补什么。
实际生产管理请结合当地土壤检测、气候条件与作物长势调整。