同样是看长势,为什么他拍一遍照片就能比出品种好坏
过去看苗、看长势,靠的是一双眼睛和多年经验;同一块地里的苗子,换个人看,结论常常不一样,隔几天再看,又变成另一个判断。作物表型组学想解决的正是这份不确定:把株高、叶面积、冠层温度这些性状,变成能拍照、能计算、能重复的数字,再拿这些数字去比品种、比处理、比抗逆表现。华昇金玛植保系统课的第079课,从平台设备讲到试验设计、图像处理和管理决策,把“用镜头量作物”这条路走一遍。
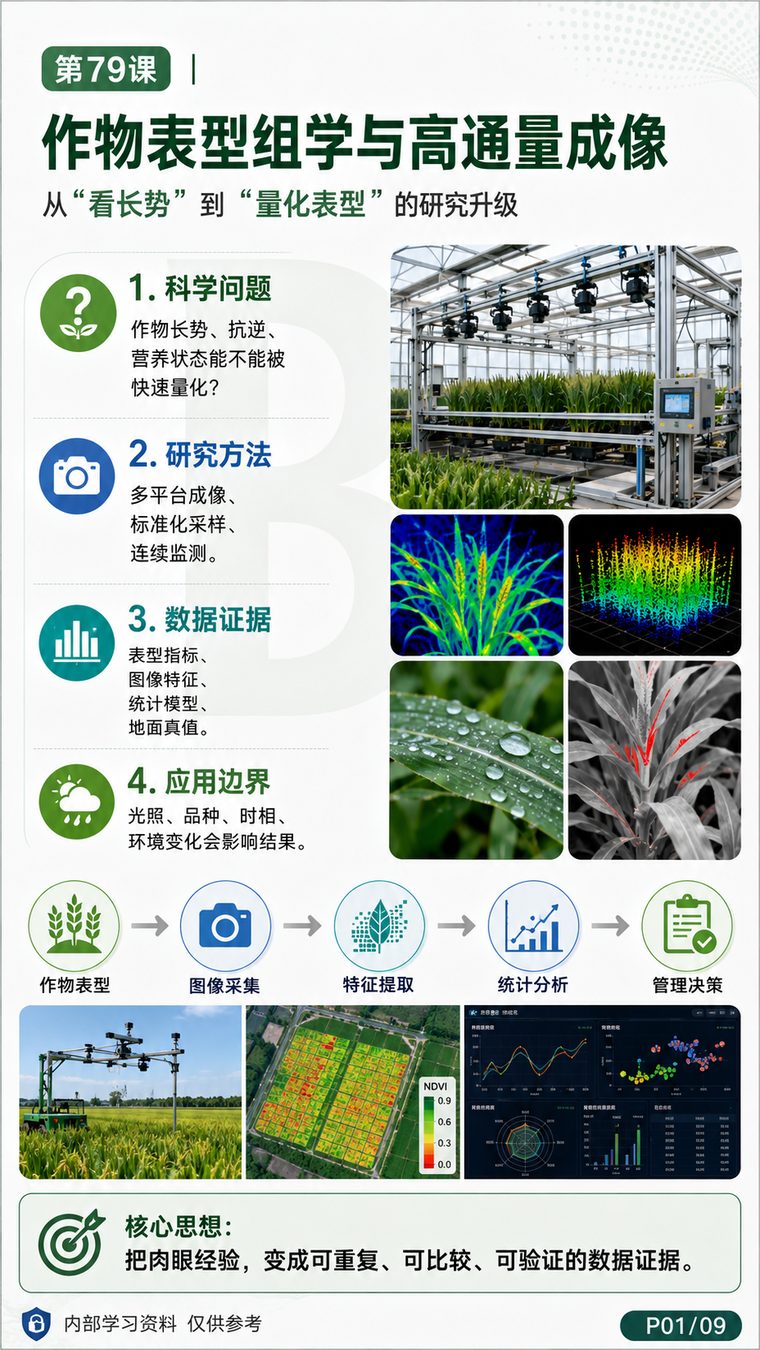
这一页是整课的地图,四块内容按顺序摆开:先提出科学问题——长势、抗逆、营养状态能不能被快速量化;再给研究方法——多平台成像、标准化采样、连续监测;然后是数据证据——表型指标、图像特征、统计模型、地面真值;最后是应用边界——光照、品种、时相、环境变化都会影响结果。页面底部那条线是全课的骨架:作物表型→图像采集→特征提取→统计分析→管理决策。四块里最容易漏掉的是最后一块,数据不落到管理动作上,前面做得再细,也只是给别人看的一组数字。
把肉眼经验,换成可比较的数据证据
作物表型组学研究的是作物看得见的性状,株高、叶面积、叶片颜色、冠层结构,以及它们随时间的变化。图上把本课范围拆成四块:要回答的科学问题、能用的研究方法、可以拿到的数据证据、还有应用上的边界。中间一条五步流程写得清楚:作物表型、图像采集、特征提取、统计分析,最后落到管理决策。旁边三张示例图分别是田间龙门架、无人机拍出的 NDVI 热力图和汇总数据的仪表盘。
图上把核心思想落在最后一句:把肉眼经验,变成可重复、可比较、可验证的数据证据。这句话也提醒,表型采集不是单纯拍照片,而是要给描述性状搭一套统一标准,否则不同人、不同天拍出的结果对不上。华昇金玛在规模化植保场景用的美添健·禾,标注 1L×12 瓶、飞防或叶面喷施、按亩用药液量配,倍数以产品实物标签为准,判断大面积长势差异时,正需要这种能横向对比的田间记录来支撑。标准统一了,同一处理在不同地块重复时才有比较的可能。
肉眼判断不稳,就用多时点成像补上
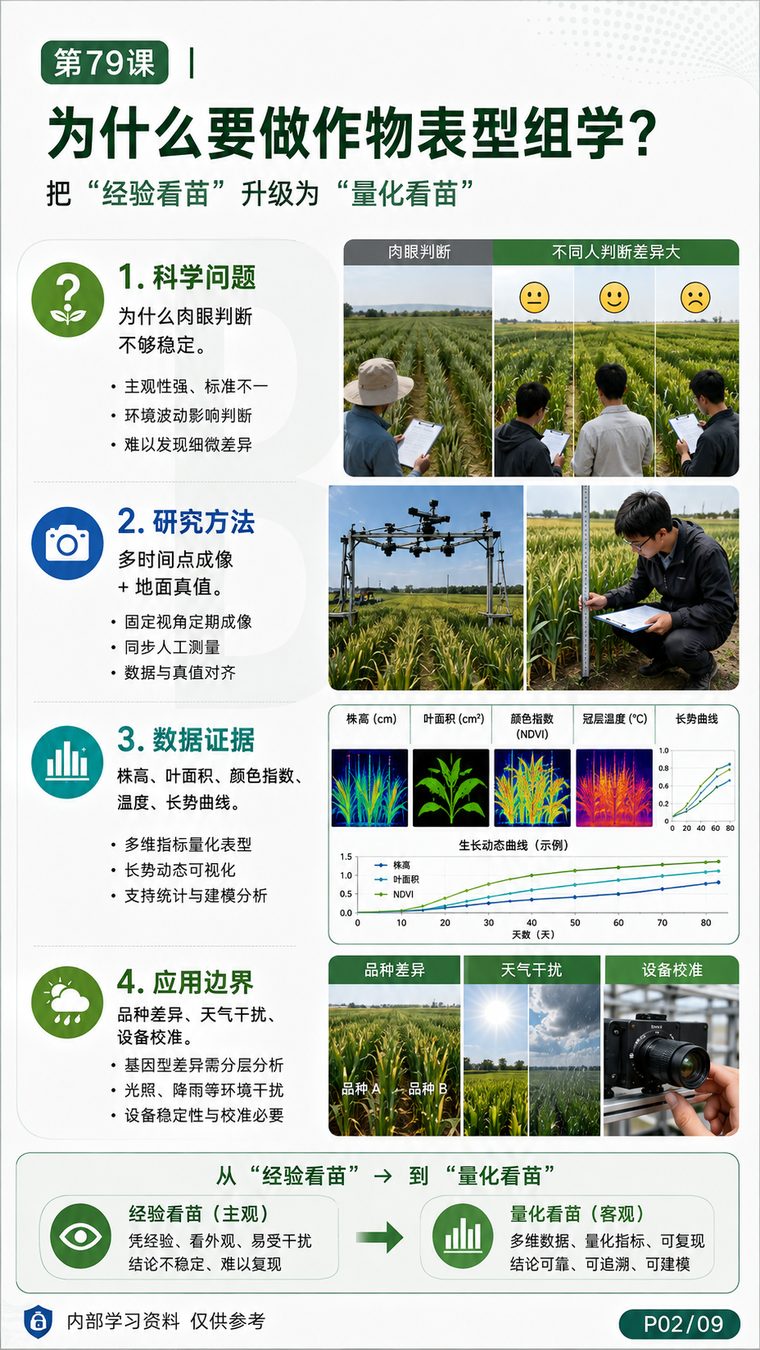
经验看苗靠的是眼力和记忆,图上列出它不稳的三个原因:主观性强、标准不一;环境一变,判断跟着变;细微差异很难用肉眼发现。所以要把“看苗”升级成“量苗”,靠多时间点成像,再配上地面真值,才把长势的差别说清楚。右下角那张生长动态曲线,横轴是 0 到 80 天,纵轴是 0.0 到 1.5,画的正是一段时间里的长势轨迹。
图上给出的量化对象很具体:株高用厘米、叶面积用平方厘米、颜色指数看 NDVI、冠层温度用摄氏度,再加一条长势曲线。这些数字凑齐,才好在品种之间、处理之间做比较。当然边界也标了出来:品种本身的差异、天气的干扰、设备的校准,都会左右结果。华昇金玛把它当成田间的“基础档案”,一侧是成像记录,一侧是管理动作,两边对着看。记录留痕,回头看才知道长势的变化是怎么发生的;只凭印象复盘,过几天就说不清了,也容易把环境波动当成品种差异。想要更稳,就把每一期的成像和真值都归档保存。
五类指标各管长势的一段
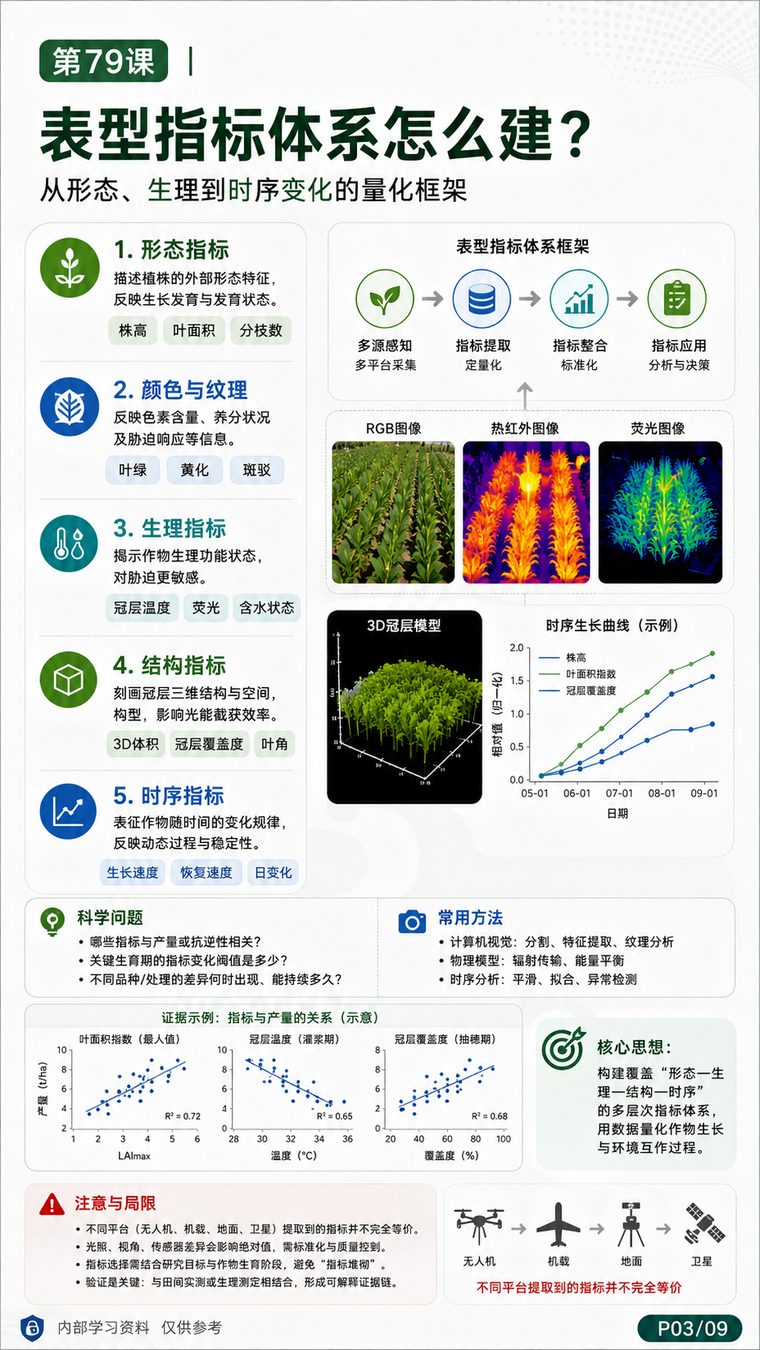
表型指标体系在图上分成五类。形态指标看株高、叶面积、分枝数;颜色与纹理指标看叶绿、黄化、斑驳;生理指标看冠层温度、荧光、含水状态;结构指标看三维体积、冠层覆盖度、叶角;时序指标看生长速度、恢复速度和日变化。五类之外,图上还给了一条框架:多源感知、指标提取、指标整合、指标应用,一环扣一环。
采集手段上,RGB、热红外、荧光三类相机各补一块,三维冠层模型和时序生长曲线把空间与时间两个维度补齐。图上还列了三条科学问题、三种常用方法——计算机视觉、物理模型、时序分析,以及三组证据示例:叶面积指数最大值处 R²=0.72,灌浆期冠层温度 R²=0.65,抽穗期冠层覆盖度 R²=0.68。做抗逆评价、把表型和产量关联起来,靠的正是这类可追溯的指标。指标要从下地那天开始记起;中途补记,关键节点已经过去,只能靠估计,而估计撑不起结论。这套记录从第一季就固定下来,往后每季都能接力用。
平台没有最好,只有配不配得上问题
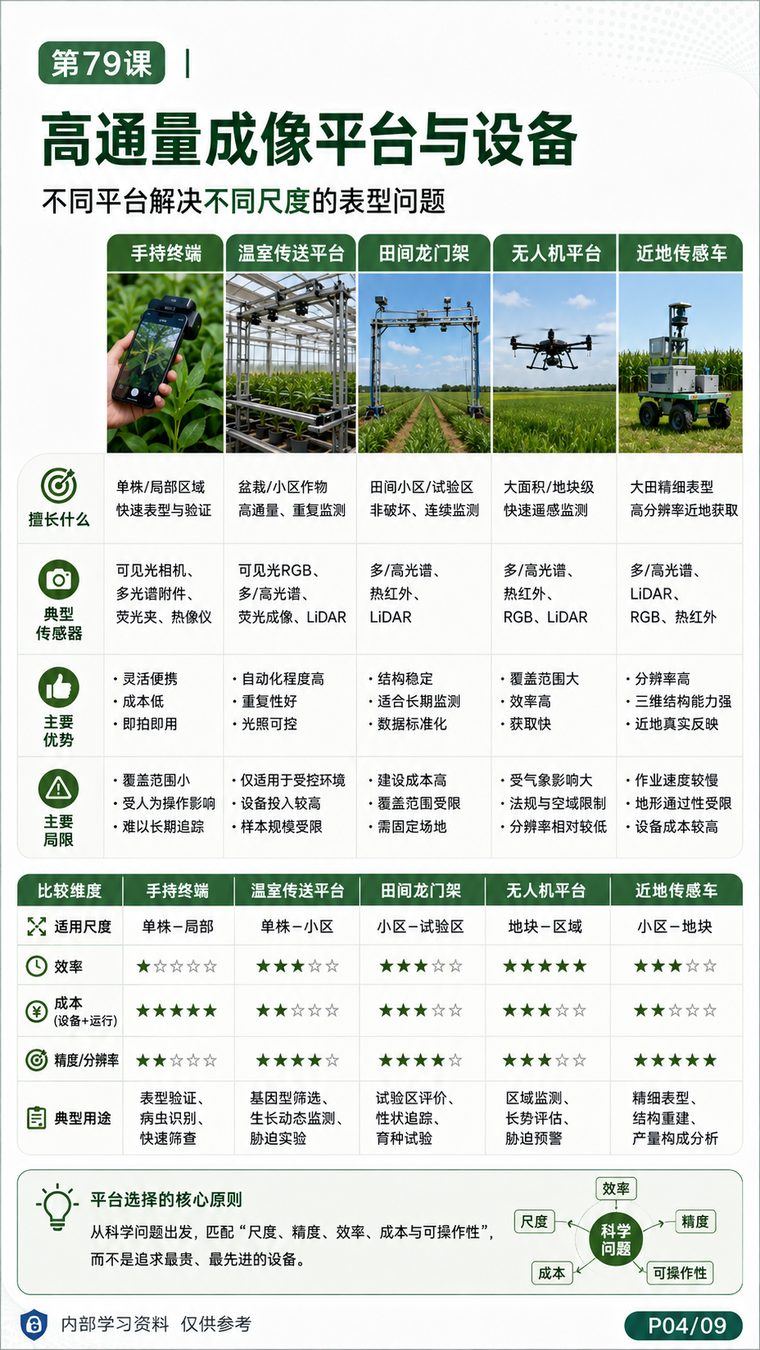
高通量成像平台在图上分成五类:手持终端、温室传送平台、田间龙门架、无人机平台、近地传感车。每类都按四行说清:擅长什么、典型传感器是什么、主要优势、主要局限。下面用五星制量化对比了五个维度——适用尺度、效率、成本、精度与分辨率、典型用途,谁强谁弱一眼能看出来。整张表的用途,就是回答“表型平台怎么选”这个问题。
图上给的核心原则是:从科学问题出发,再在效率、精度、可操作性、成本、尺度之间取平衡。换句话说,选平台不是越贵越好,而是看要测的性状、地块大小和人力条件。想弄清无人机表型和近地传感的区别,看的就是效率与精度这两栏。华昇金玛在做规模化地块的长势巡查时,一侧用无人机平台做面,一侧用田间记录做点,两边对上看,判断更稳。用哪一类平台、配什么传感器,最终都要回到要回答的问题上,别为了工具本身去设计试验。
设计站不住,后面的分析都白搭
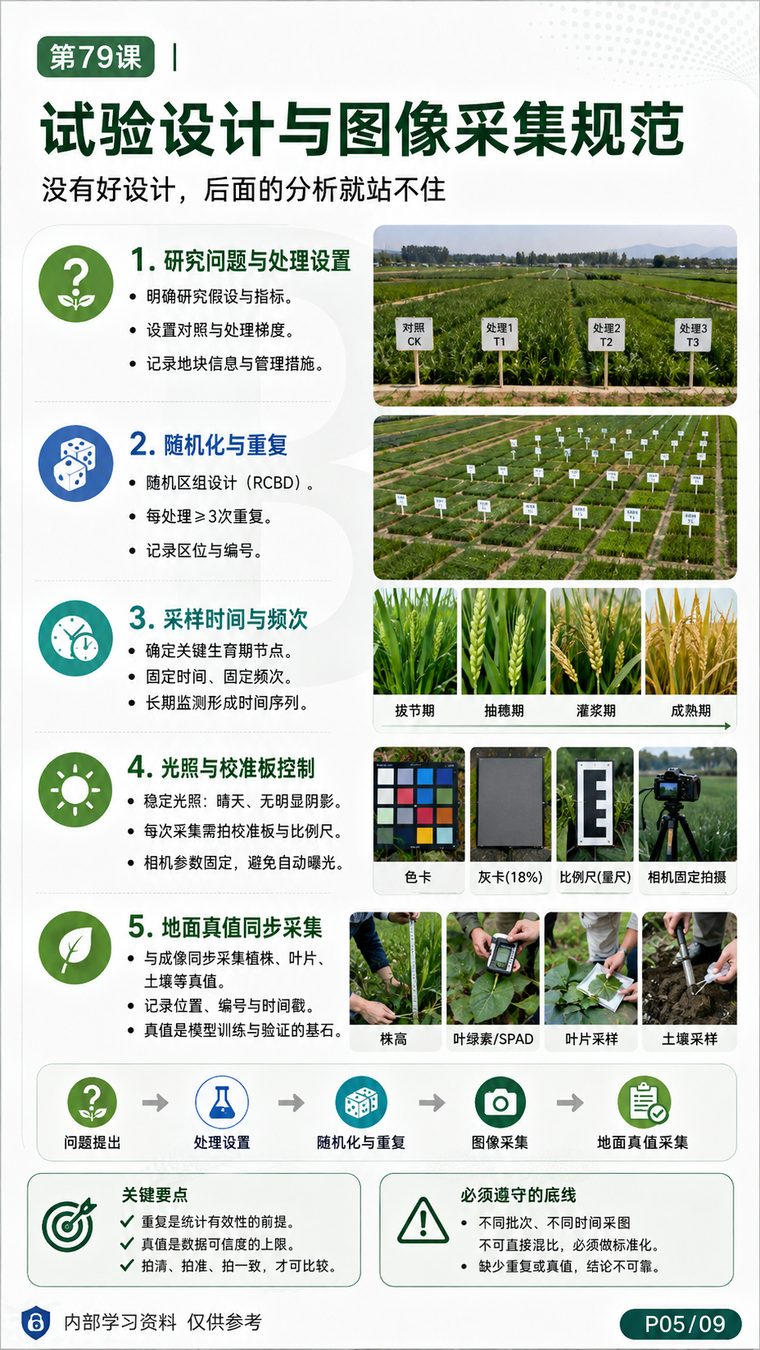
图上第一句就是“没有好设计,后面的分析就站不住”。五个模块依次是:对照 CK 与处理 T1、T2、T3 的设置;随机区组;按拔节期、抽穗期、灌浆期、成熟期排的时序;色卡、18% 灰卡、比例尺量尺和固定机位;株高、叶绿素 SPAD、叶片采样和土壤采样。整套流程是问题提出、处理设置、随机化与重复、图像采集、地面真值采集。
图上强调了两条底线:同一处理要有重复,采集条件要统一,包括相同高度、相同角度、相同光照参考。少了这两条,图像之间的差异就分不清是处理带来的还是拍摄带来的。批次效应怎么校正、训练集和验证集怎么分,前提也在这里——采集本身没规矩,再好的统计方法也补不回来。华昇金玛在示范田做对比时,同样按这个思路把处理和对照分区分开、固定机位。机位固定下来,同一块地每期的照片才能叠在一起比,差在哪一格一眼就能找到;省了这步,看似省事,实际是把后面的判读难度全留给自己。
把照片变成一张能分析的数据表
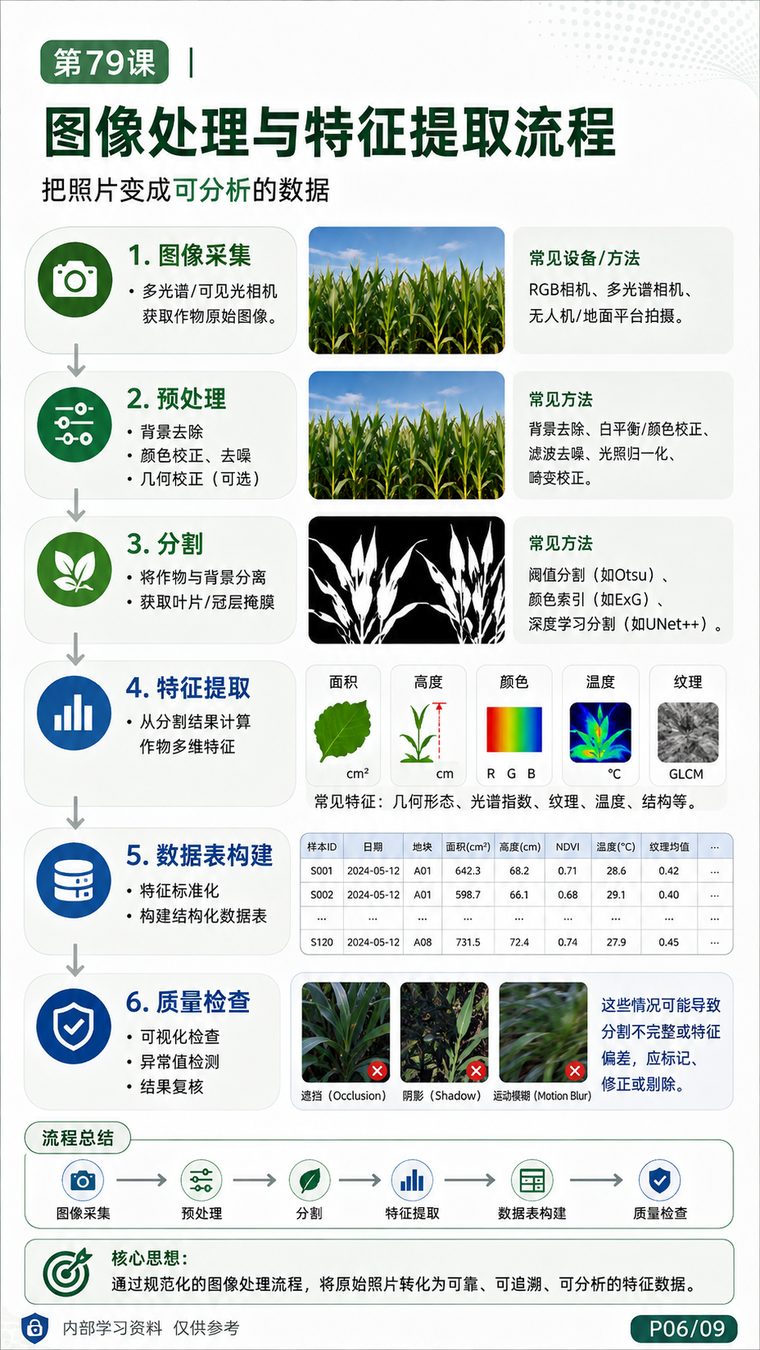
照片要想变成数据,图上给了六步:图像采集、预处理、分割、特征提取、数据表构建、质量检查。预处理做的是背景去除、颜色校正、去噪和几何校正;分割用上 Otsu、ExG、UNet++ 这些方法,把植株和背景分开;特征提取量的是面积、高度、颜色、温度和纹理。最后汇成一张表,字段有样本 ID、日期、地块、面积平方厘米、高度厘米、NDVI 和温度摄氏度。
这张图把核心思想说得很直白:规范化流程能把原始照片转成可靠、可追溯、可分析的特征数据。所以同一批数据换个人来量,结果也该对得上。质量检查最容易被跳过,遮挡、阴影、运动模糊都会污染数值,图上专门把它列进流程。华昇金玛的做法是先把采集与处理规矩立住,规矩稳了,后面拿去解释长势和做营养诊断才有支撑。流程固定后,同一块地不同批次的数据才具备可比性,也才经得起回头看;一批批攒下来,就成了地块自己的历史档案。
先说一处容易看串的地方。这套课件左上角有一栏编号,几页的写法并不一致:P06 那页标的是「第79课」,P07 标「第7课」,P08 标「第8课」,而三页右下角的页码分别是 P06/09、P07/09、P08/09。同一套课件里同时出现「第79课」和「第7课」两种写法,说明左上角这一栏是原始课件自带的版式字段;两种写法并存的原因,现有原件里没有说明,不能据此反推成「第 7 节」「第 8 节」这类小节号。本课在系统课里是第 079 课(网址 course-079),页序认右下角的 P0x/09。
会算数据,更要会判断证据强弱
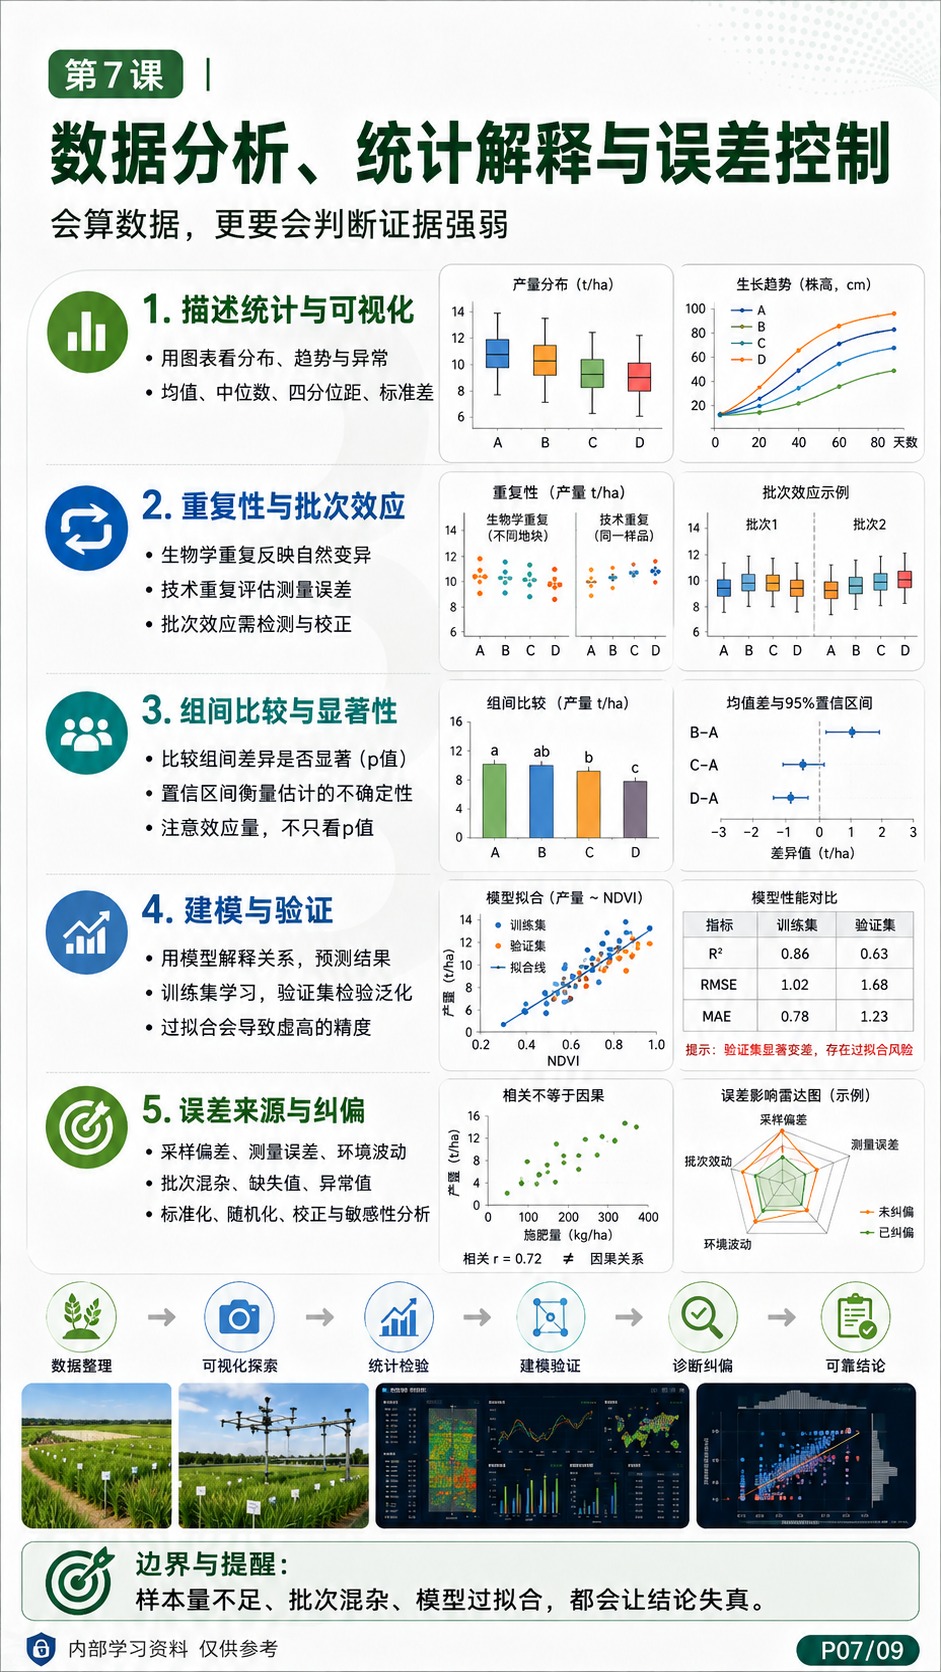
图上把这一页分成四块。描述统计与可视化:用图表看分布、趋势和异常,算的是均值、中位数、分位数和标准差。重复性与批次效应:生物学重复反映自然变异,技术重复评估测量误差,批次效应要先检测再校正。组间比较与显著性:比组间差异是否显著,看 p 值也要看置信区间,更要注意效应量,图上专门写了一行「相关 r=0.72 不等于因果关系」。建模与验证:训练集学习、验证集检验泛化,图里的模型性能对比摆得很清楚,训练集 R² 0.86、验证集 0.63,验证误差明显更宽。
这一页的落点在图底那行边界与提醒:样本量不足、批次混杂、模型过拟合,都会让结论失真。误差来源与纠偏列了采样偏差、测量误差、环境波动、缺失值、异常值,对策是标准化、随机化、校正和敏感性分析。华昇金玛的做法是先立证据规矩再谈结论:一个差异值只有配上重复、区间和效应量,才拿去指导田间决策;训练集和验证集分开,是所有模型类结论的门槛。
表型成像真正能解决哪些问题
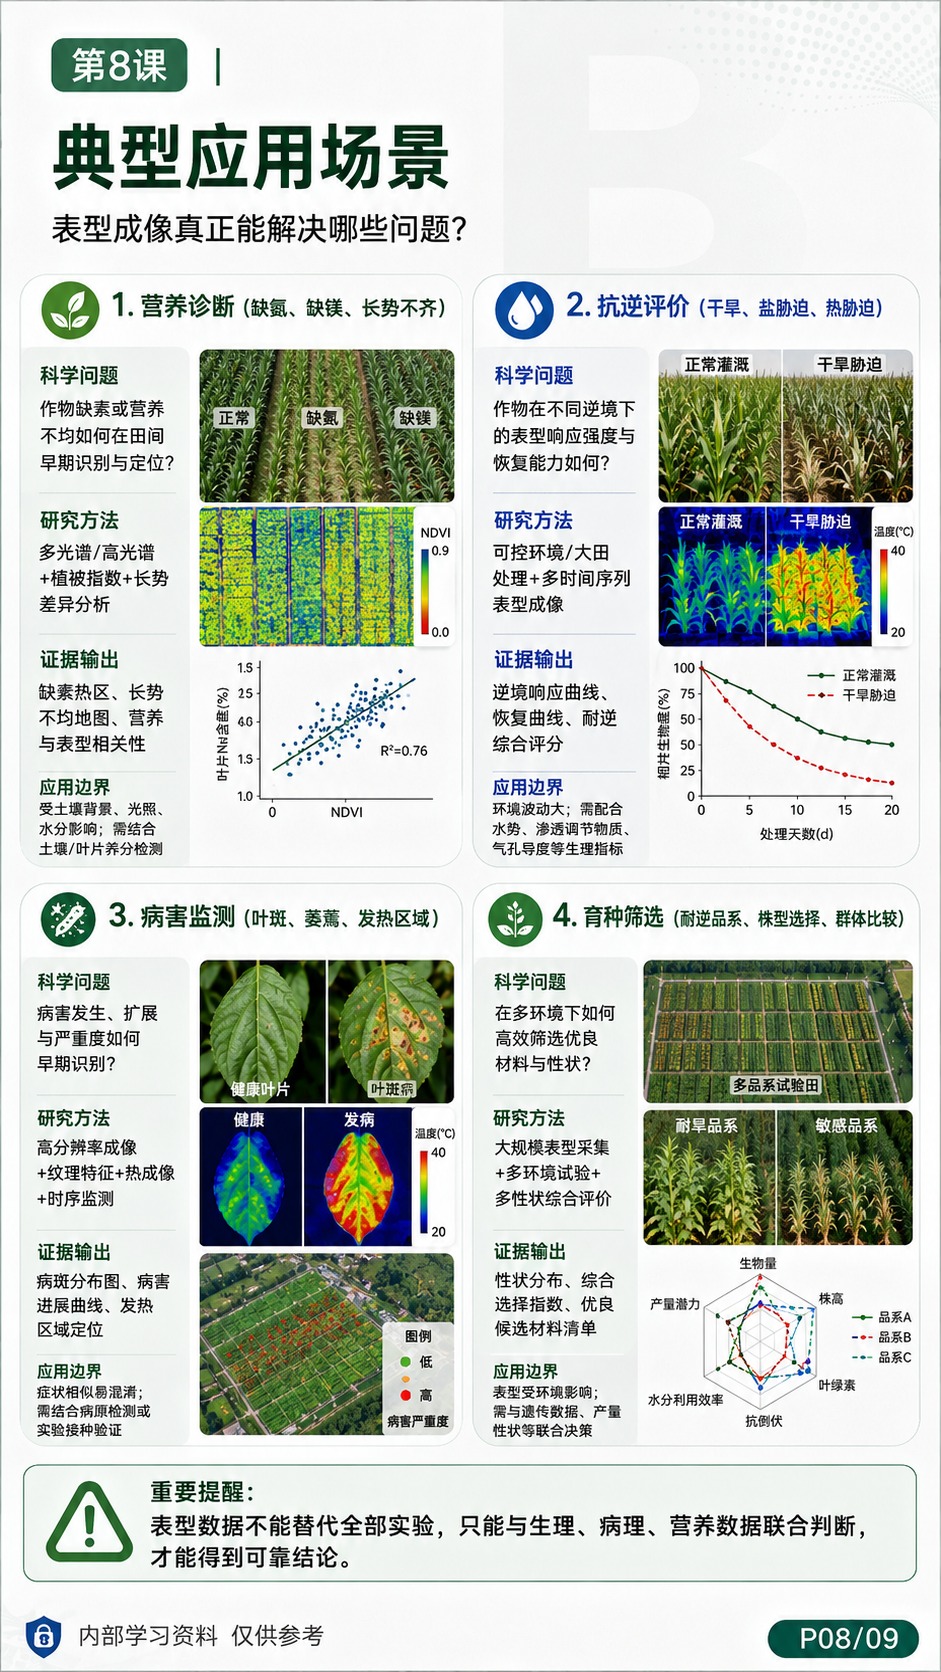
图上摆了四个典型场景。营养诊断,针对缺氮、缺镁、长势不齐,问的是不同缺素在图像上表现什么、能不能反过来指导施肥。抗逆评价,针对干旱、盐胁迫、热胁迫,看作物在逆境下形态与生理怎么变、能不能快速识别抗逆差异。病害监测,覆盖叶片、整株到田间尺度,做病斑识别、严重度分级和扩散监测。育种筛选,靠表型组、梯度对应和群体比较,把群体间的差异变成选种依据。
四个场景用的是同一套底子:采集规范、特征提取、统计解释,差别只在指标和尺度。华昇金玛的做法是按场景倒推采集方案——先想清楚这张图要回答什么问题,再定拍摄的高度、时间和指标。问题定不准,拍回来的图再多也算不出结论。
数据要落到能执行的管理动作上
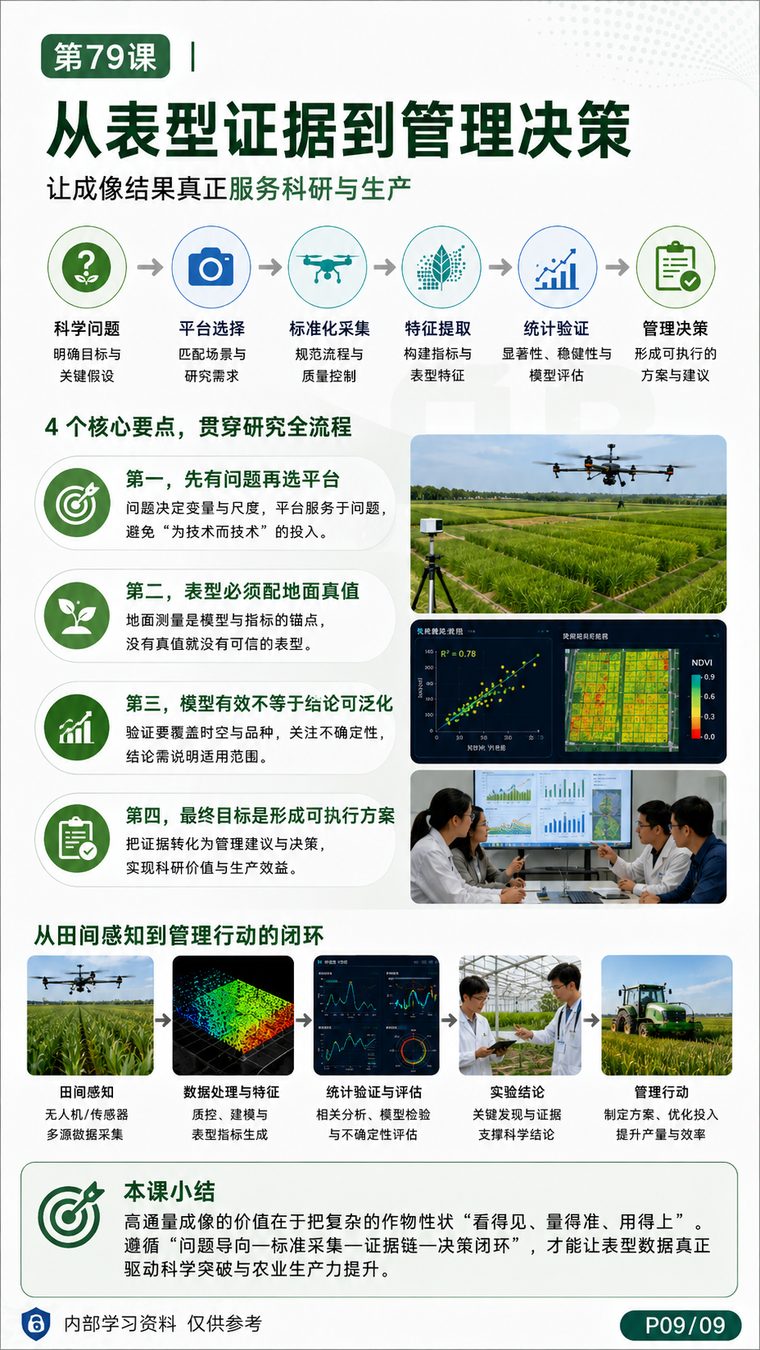
从表型证据到管理决策,图上画了六步:科学问题、平台选择、标准化采集、特征提取、统计验证、管理决策。四个核心要点也很实在:先有问题再选平台;表型必须配地面真值;模型有效不等于结论可泛化;最终目标是形成可执行方案。下面那个闭环用了五个节点,把从田间感知到管理行动接成一轮,走完还能再回起点复查。
本课小结三个词:看得见、量得准、用得上。前者靠成像,中段靠流程与统计,末段靠把结论转成具体动作。华昇金玛在滴灌冲施场景用的美添健·灌,标注 5L×4 桶、冲施或滴灌、全程 2–3 次,单次用量以产品实物标签为准,正是把表型结论落到水肥执行的一段;区间怎么调,仍要按地块与产品说明来定。数据从地里来,最终也要回到地里去。判读时多问一句:这份结论是在什么平台、什么天气、什么生育期拿到的,换一块地还成不成立。经得起这层追问,表型才算真的用上了。
常见问题解答
Q:作物表型组学和自己下地看苗,差别在哪?
Q:表型成像一定要有地面真值吗?
Q:图像分割和超绿指数是干什么用的?
Q:五种成像平台,小地块该选哪种?
Q:有了表型数据,怎么落到田间管理?
实际生产管理请结合当地土壤检测、气候条件与作物长势调整。