判断一片叶有没有生病,过去常靠肉眼和经验;可有些变化在肉眼可见的症状出现之前,就已经发生在化学层面。拉曼光谱读的正是这一层信息——用激光照样品,靠分子键振动产生的散射光反推成分,因此常被叫作植物的化学指纹诊断。华昇金玛植保系统课第118课围绕这条线展开:拉曼峰位对应哪些化学键,信号太弱时SERS怎么把它放大,叶片、果皮和根际分泌物分别怎么测,空间成像能看到什么,以及从峰位到模型、再到验证的完整链条。
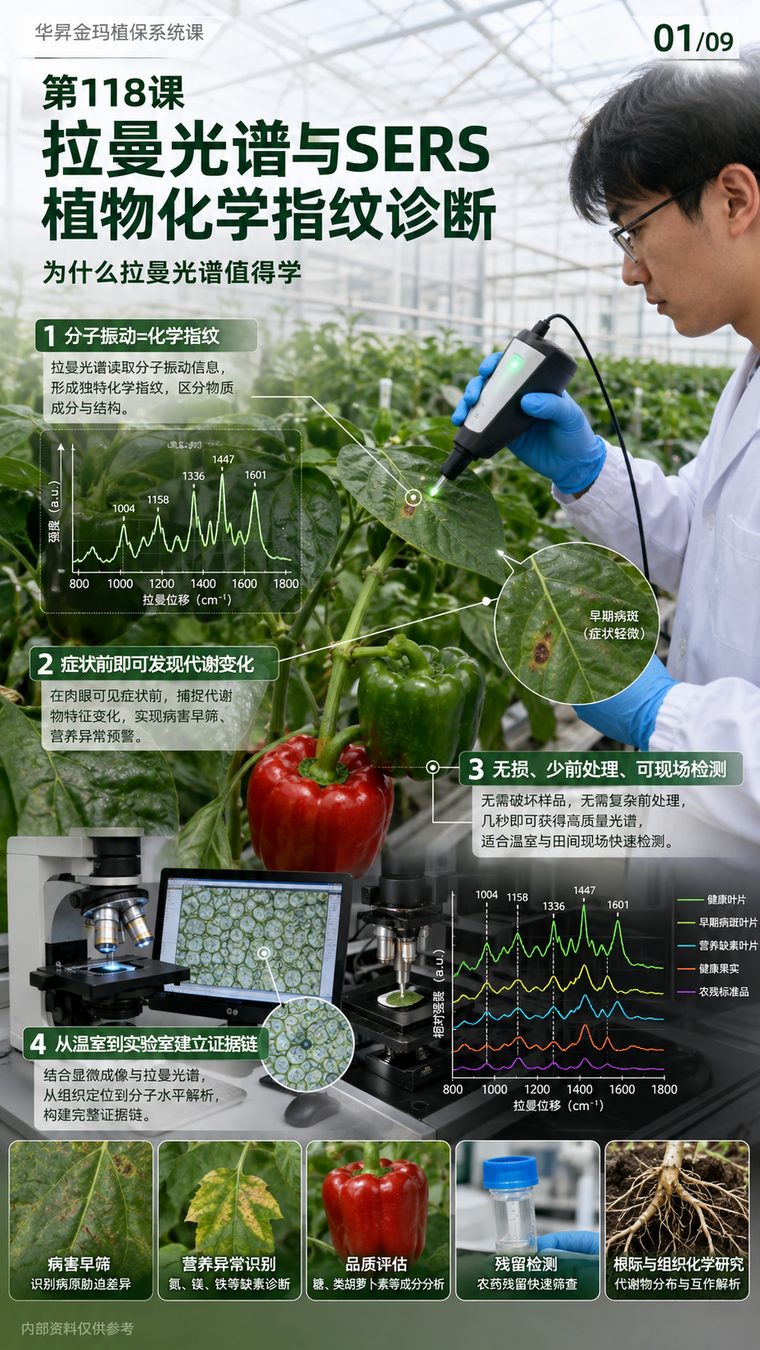 01/09 丨手持拉曼与植物检测定位
拉曼光谱进入植保现场,起步形态就是手持机。图上给出的激发波长是785nm,配套的峰位清单包括1004、1158、1336、1447、1601、2930以及3300cm⁻¹附近这些常被引用的位置,每一个位置背后都对应一类化学键。下面的五张应用卡把可测对象摊开:叶片、果皮果肉、根际分泌物、汁液洗脱液、以及需要空间信息时的成像样品。也就是说,同一台仪器,换一种采样方式就能面向不同的部位。
这类设备的定位是现场快筛,而不是替代实验室的全成分分析。它给出的是一组峰位和峰强,读出来的信息要结合样品的品种、部位和生长阶段来判断。华昇金玛把这类诊断设备放到植保服务里时,通常先明确它的用途边界——用来找异常、比对处理前后的变化,而不是拿一次读数给整块地定性。
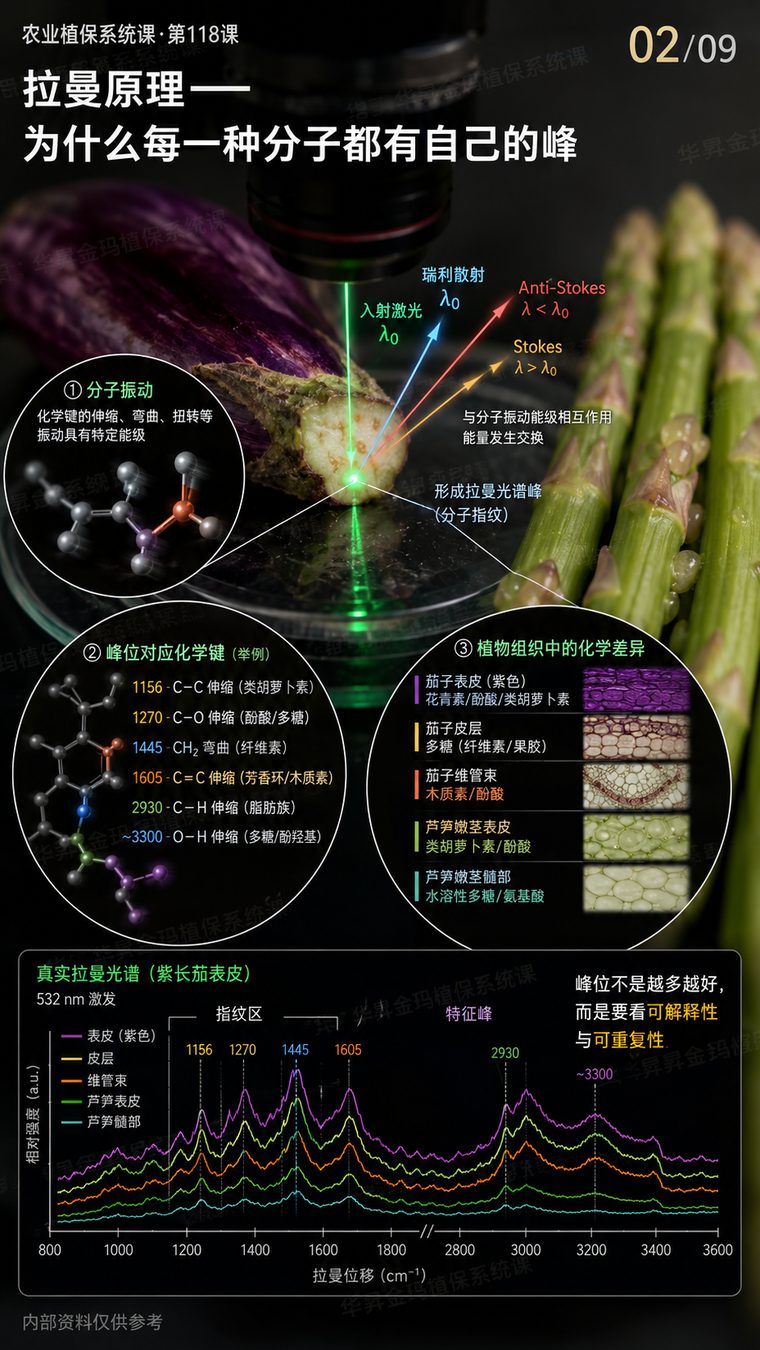 02/09 丨峰位与化学键的对应
要读懂一条拉曼光谱,先认得峰位。图上从散射原理讲起:入射光与分子作用后,出现瑞利散射和斯托克斯、反斯托克斯散射,其中发生能量交换的那部分才携带分子信息。接着把常见峰位与化学键对应起来:1156cm⁻¹对应C–C骨架,1270cm⁻¹对应C–O,1445cm⁻¹对应CH₂弯曲,1605cm⁻¹对应C=C,2930cm⁻¹对应C–H伸缩,3300cm⁻¹附近对应O–H。图下还给了532nm激发下紫长茄表皮和芦笋表皮、髓部的真实光谱做实例。
这层对应关系是后续所有判断的基础。酚类物质、糖、脂质、木质素这些成分各自有特征峰,峰强的变化就代表含量的变化。华昇金玛在服务里强调的也是这一点:先把峰读准、把同部位同条件固定下来,再谈它和长势、病害的关联,否则换个人测、换个位置测,结果就对不上。
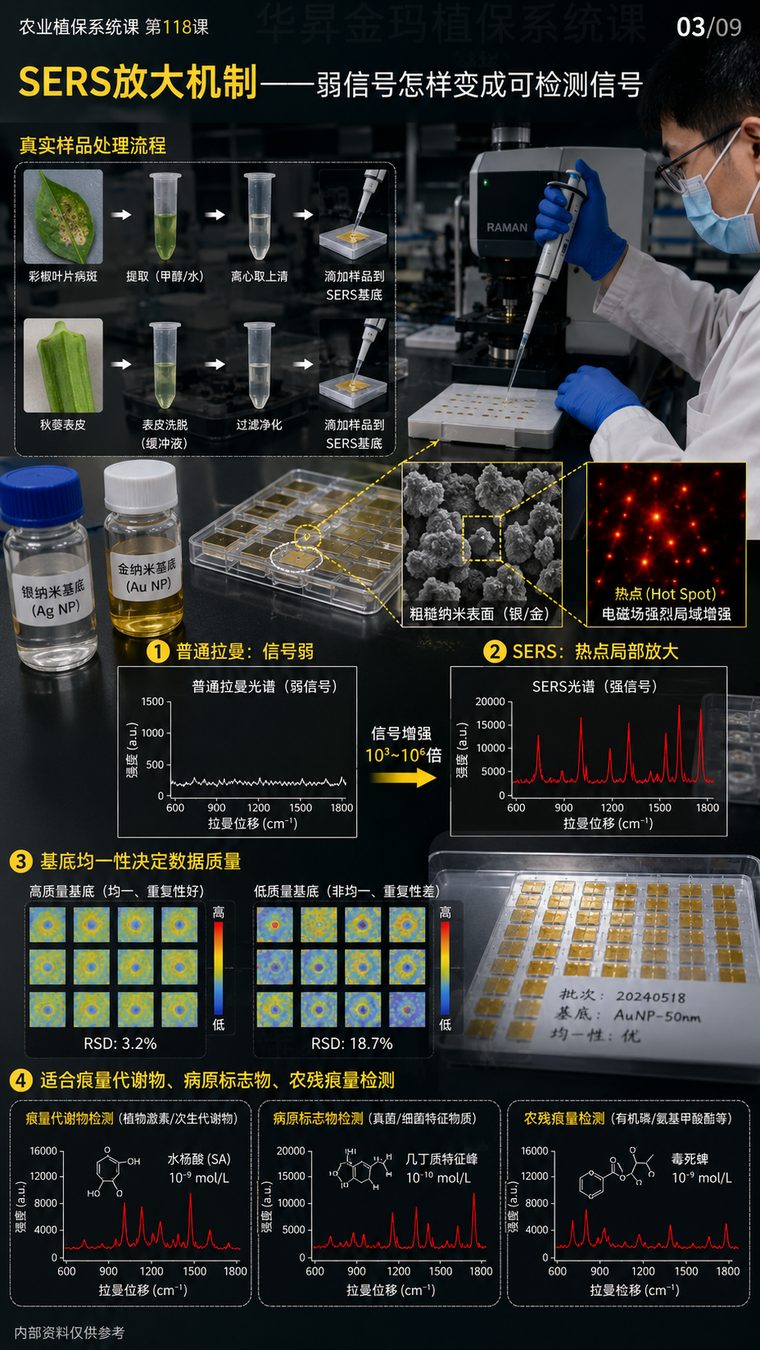 03/09 丨SERS 增强与基底选择
植物组织里的成分含量低,信号常常弱到读不出来。图上讲的是SERS的放大机制:样品先处理成提取液,比如取病斑叶或秋葵组织、提取、离心取上清,再滴加金色的SERS基底,让目标分子吸附到金属表面,信号随之被放大。基底有银纳米颗粒和金纳米颗粒之分,前者增强更强但重复性差,相对标准偏差18.7%,后者稳定性更好,可降到3.2%。整体增强倍率在10³到10⁶之间。图的样例批次是20240518,基底标注AuNP-50nm。
基底怎么选,直接决定数据能不能用。追求极限灵敏度可以选银基底,但要接受重复性波动;要批量比对和长期跟踪,金基底的稳定性更划算。华昇金玛在涉及SERS的检测方案里,会把基底批号和制备条件写进记录,因为基底一旦换批,峰强就可能整体漂移,跨批次的数据不写清条件就没法比。
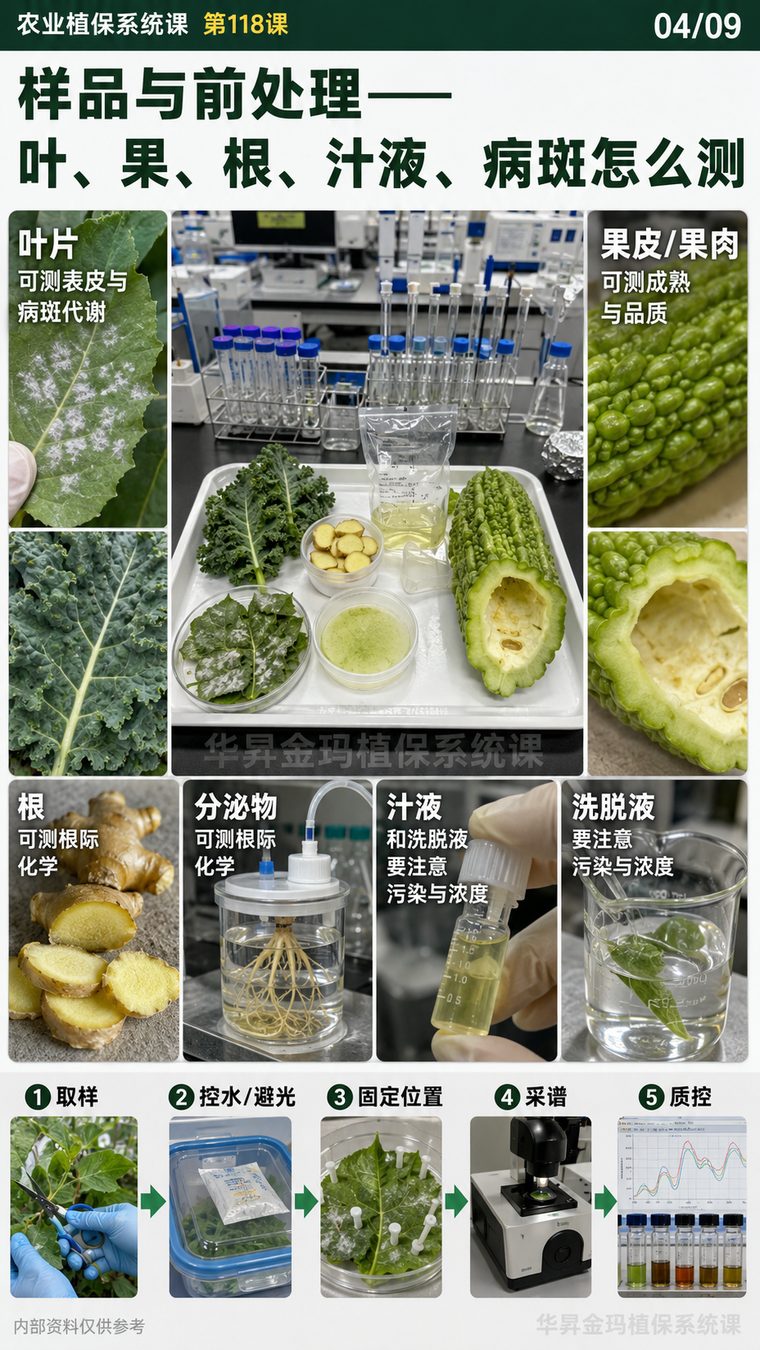 04/09 丨样品与前处理五个步骤
拉曼的样品准备,比很多人想的要讲究。图上给出五个步骤:取样、控水避光、固定位置、采集光谱、质量控制。可测的部位也分几类——叶片、果皮与果肉、根与分泌物、汁液洗脱液,不同部位的取样手法和背景干扰都不一样。控水与避光是为了压掉水分和荧光对光谱的干扰;固定位置是为了让每次采到的都是同一块组织;质控则用来剔除异常谱图。
这五步里,固定位置容易被忽略,也直接影响结论。同一片叶子的主脉两侧、叶尖和叶基,成分本就有差异,如果不固定位置,前后两次测的其实是不同的东西。华昇金玛把这类规范写进操作流程,正是为了让检测结果能用于处理前后的对比,而不是只留一张好看的谱图。
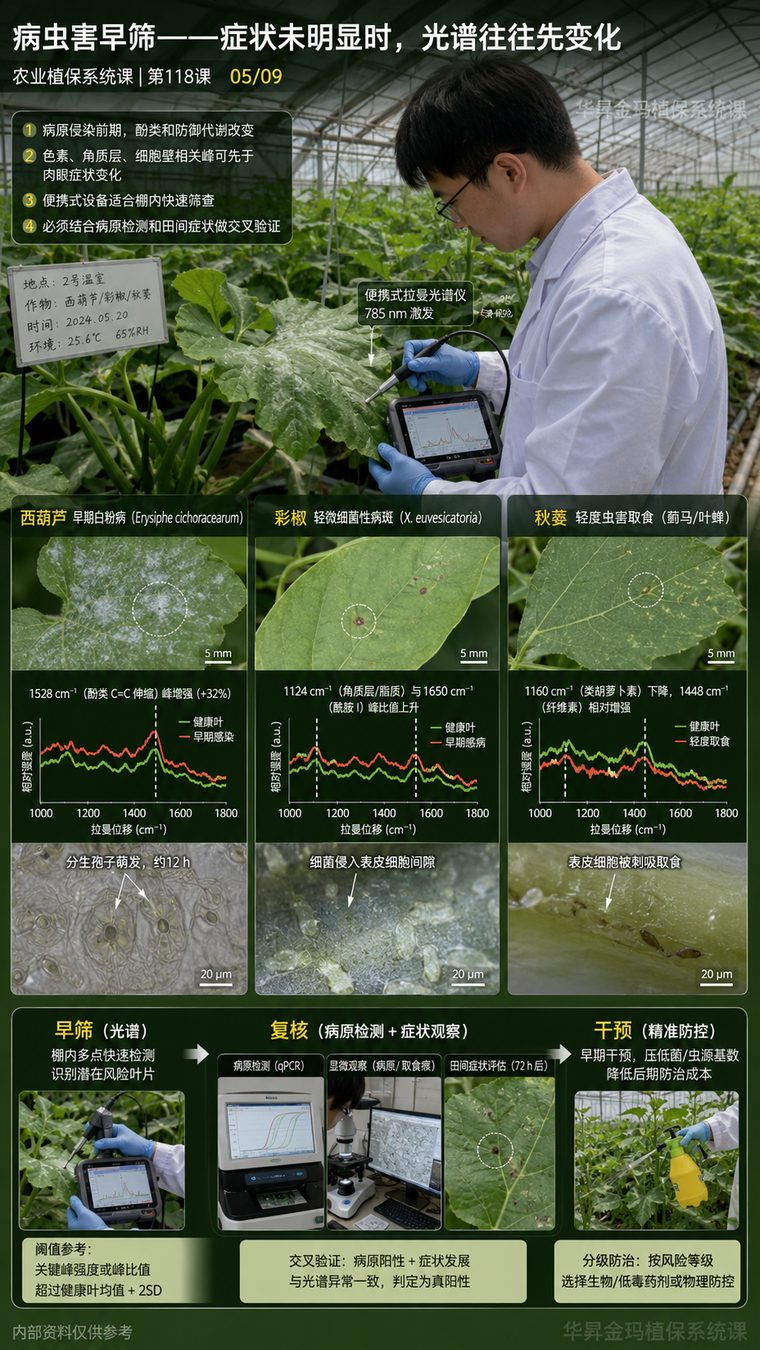 05/09 丨病虫害的早期拉曼筛查
病害早筛是拉曼被看重的主要用途之一。图上给的例子是三组:西葫芦白粉病,1528cm⁻¹的酚类C=C峰增强约32%,而此时分生孢子萌发大约在12小时左右;彩椒细菌性病斑,1124与1650cm⁻¹的峰强比值上升;秋葵轻度虫害,1160cm⁻¹下降、1448cm⁻¹相对增强。背景信息记的是2号温室、2024年5月20日,环境25.6℃、相对湿度65%。
这些特征峰的变化,往往出现在肉眼可见的病斑之前,这正是早筛的价值所在。对种植端来说,早一步发现意味着可以用更温和的手段先控住,而不是等病斑成片再加大药量。以白粉病和细菌性病斑为例,前期可用枯草芽孢杆菌按灌根或基施500g/亩·次、定植前后用的思路做预防,把根际和叶际的生态先稳住;确诊后再按病害类型补上针对性药剂。
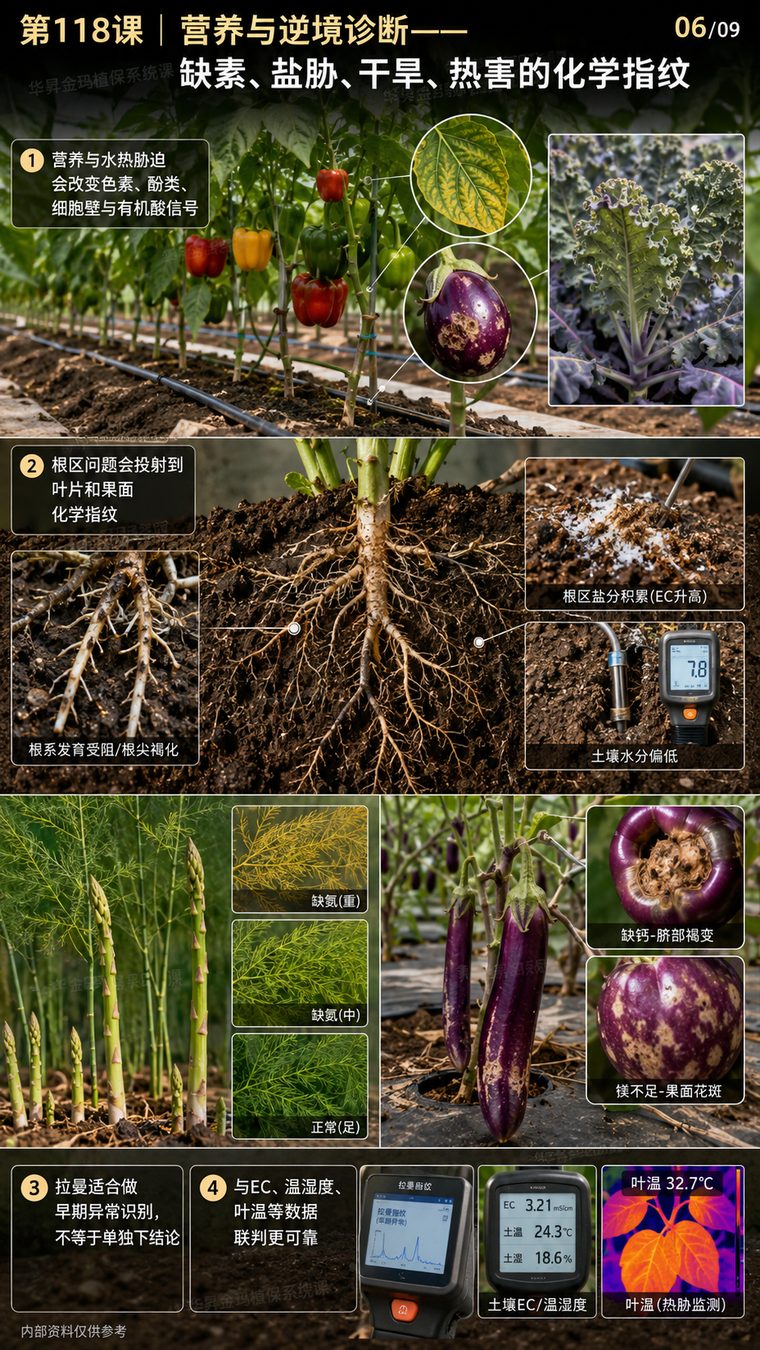 06/09 丨营养缺素与逆境诊断
营养与逆境诊断,拉曼走的是另一条线索。图上给的是对照:缺氮设重度、中度、正常三档,光谱随缺氮程度成梯度变化;缺钙表现为脐部褐变,缺镁表现为果面花斑,两者都在相应特征峰上留痕。旁边记录了当天的环境与土壤数据:土壤电导率3.21mS/cm、土温24.3℃、土壤含水18.6%、叶温32.7℃。把这些数值和光谱放在一起,才能判断是养分本身不够,还是根系吸收受了环境限制。
这一步的意义在于区分"真缺"和"假缺"。叶片黄化既可能是缺素,也可能是盐分偏高、低温或根系受损导致吸不上来,单看叶色分不清。华昇金玛在诊断这类问题时,会把根区指标和光谱结果一起看:如果是缺钙引起的脐腐或裂果,用维植钙按叶面1000–1500倍、幼果期连喷2–3次补;如果根区盐分偏高,则先处理盐分和灌溉,而不是继续加肥。
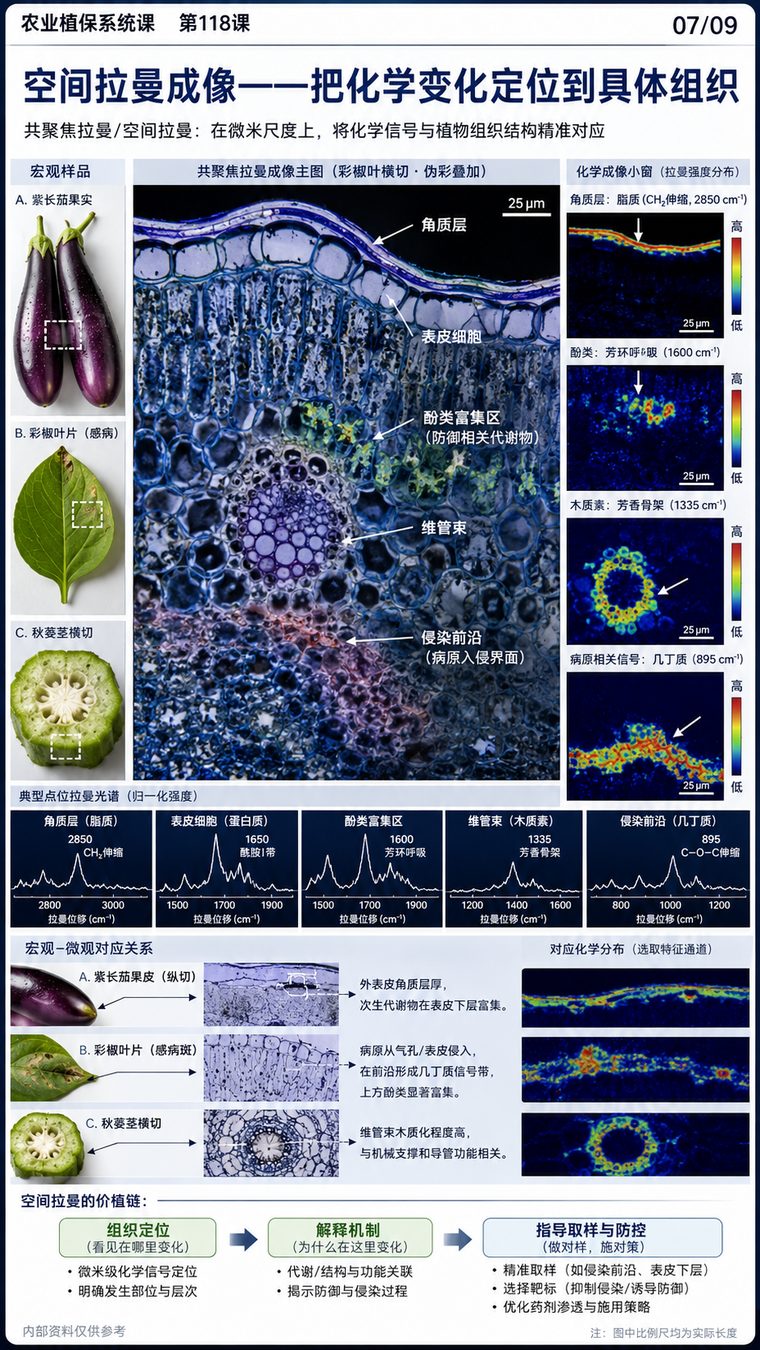 07/09 丨空间拉曼的成分成像
把检测从一点扩到一片,靠的是空间拉曼成像。图上是一张彩椒叶横切的伪彩图,标注了角质层、表皮细胞、酚类富集区、维管束和侵染前沿,比例尺25μm。几个特征通道分别对应不同成分:2850cm⁻¹看脂质,1600cm⁻¹看酚类,1335cm⁻¹看木质素,895cm⁻¹看几丁质。侵染前沿会被单独标出来,因为那里通常是酚类开始富集的位置。
这类图回答的是"成分分布在哪儿",而不是"一共有多少"。同样一片叶,酚类集中在侵染前沿,说明作物已经在局部启动防御;木质素在维管束附近增强,可能与组织的加固有关。华昇金玛在解释这类结果时,更愿意把它当作机理层面的证据,用来理解为什么某些管理措施有效,而不是当成一张可以直接下处方的图。
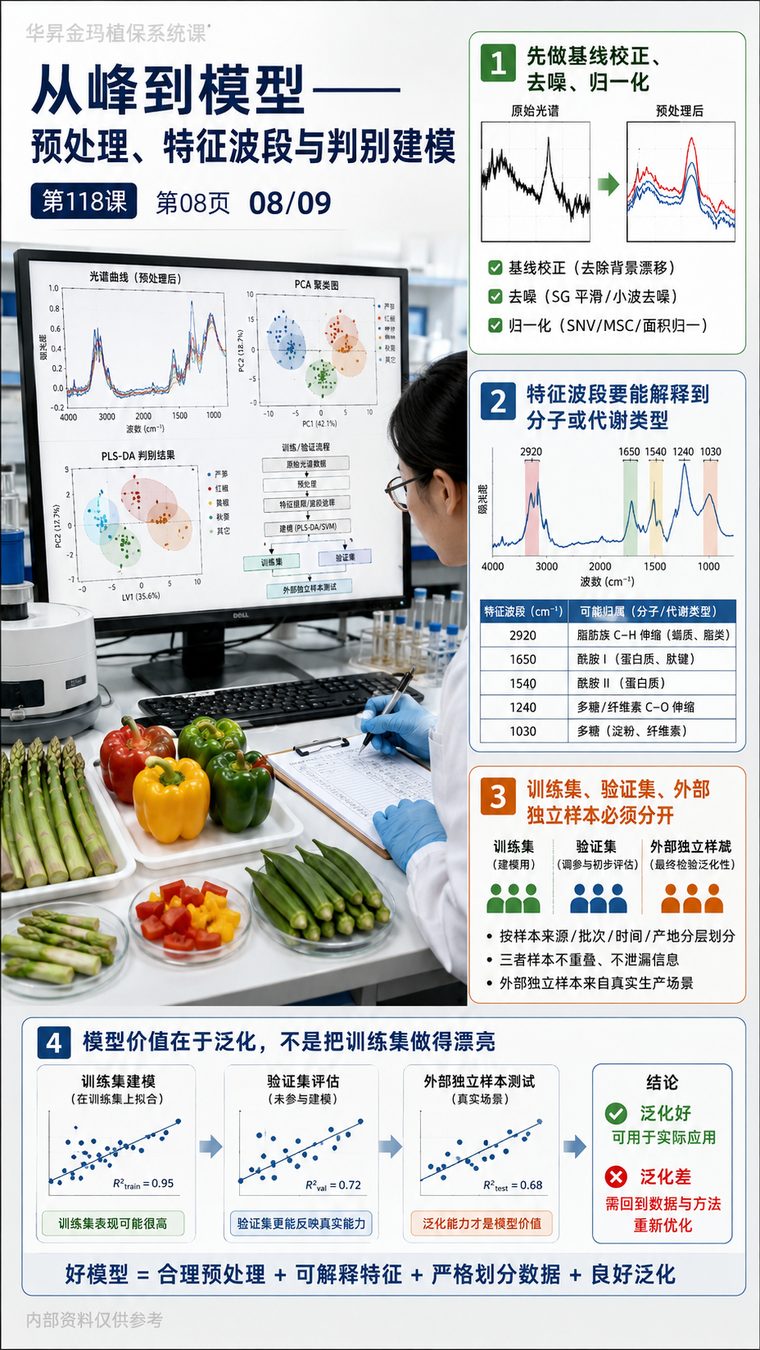 08/09 丨从特征峰到诊断模型
从峰位到能用的模型,中间隔着好几步。图上先做PCA聚类,第一主成分解释35.6%的方差,把样品大致分开;再用PLS-DA做判别。筛选出来的特征波段是2920、1650、1540、1240、1030cm⁻¹这几个位置。模型表现给的是训练集决定系数0.95、验证集0.72、测试集0.68,三段数据的落差本身就说明了问题——训练得再好,一到新数据就掉下来。
这个落差是拉曼建模的常态,因为光谱维度高、样品量往往不大,很容易把噪声学成规律。选特征波段、控制模型复杂度、留出独立的测试集,都是必要的约束。华昇金玛在交付这类模型时,会同时说明它适用的作物、部位和批次范围,超出范围的样品不建议直接套用,需要补充样本再校准。
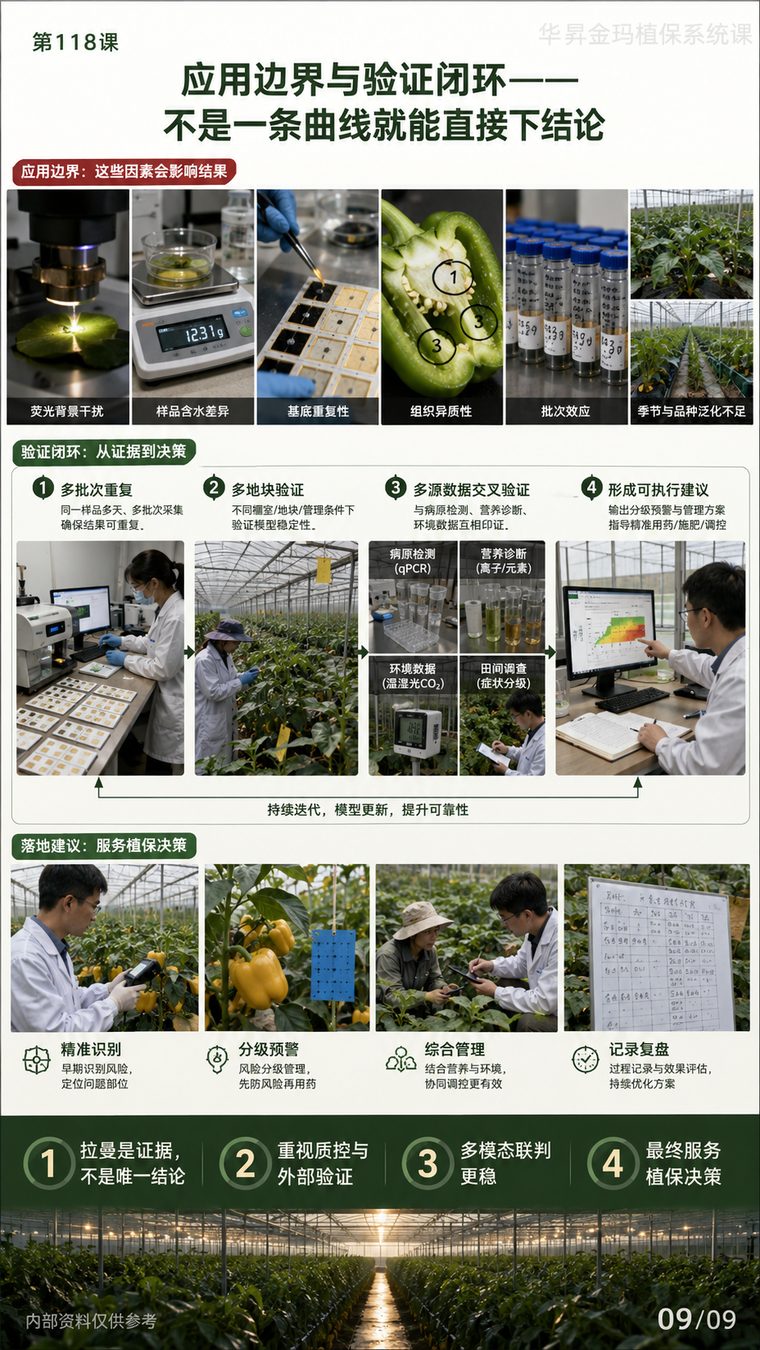 09/09 丨应用边界与验证闭环
拉曼的边界,主要来自荧光与含水量这两件事。图上列了五类影响因素:荧光背景会淹没弱峰,样品含水差异会改变散射和峰位,基底的重复性影响跨批比较,组织异质性让同一样品不同位置读数不同,季节与品种的变化则会让模型泛化变差;其中含水差异给出的样例是123.1g这样的量级差。图下给出验证的四步,用来把模型在不同条件下过一遍。
把这些因素摆出来,是为了让使用者知道什么情况下读数不能当真。含水差异大的样品要比对就先把状态统一,换季节、换品种就重新积累样本,基底换批就重做标定。华昇金玛在相关的检测服务里,会把这套验证流程和适用条件一并交付,与其只报一个准确率,不如把边界和复验要求讲在小结前面。
实际生产管理请结合当地土壤检测、气候条件与作物长势调整。