病害预测模型听起来很技术,落到田间其实就三件事:喂给它什么数据、怎么训练、训完怎么用。输入变量要收齐哪五类,什么叫发病、什么叫未发病要先定义清楚,温湿光雨怎么变成可计算的信号,规则、统计和机器学习三种建模思路各有什么取舍,以及甲地好用的模型为什么不能直接搬到乙地。评价模型时不能只盯准确率,漏报和提前量同样要看;训完的结果还要接回田间的监测、行动与再训练。模型只是把已知规律算得更快,能不能用取决于数据质量与适用边界。
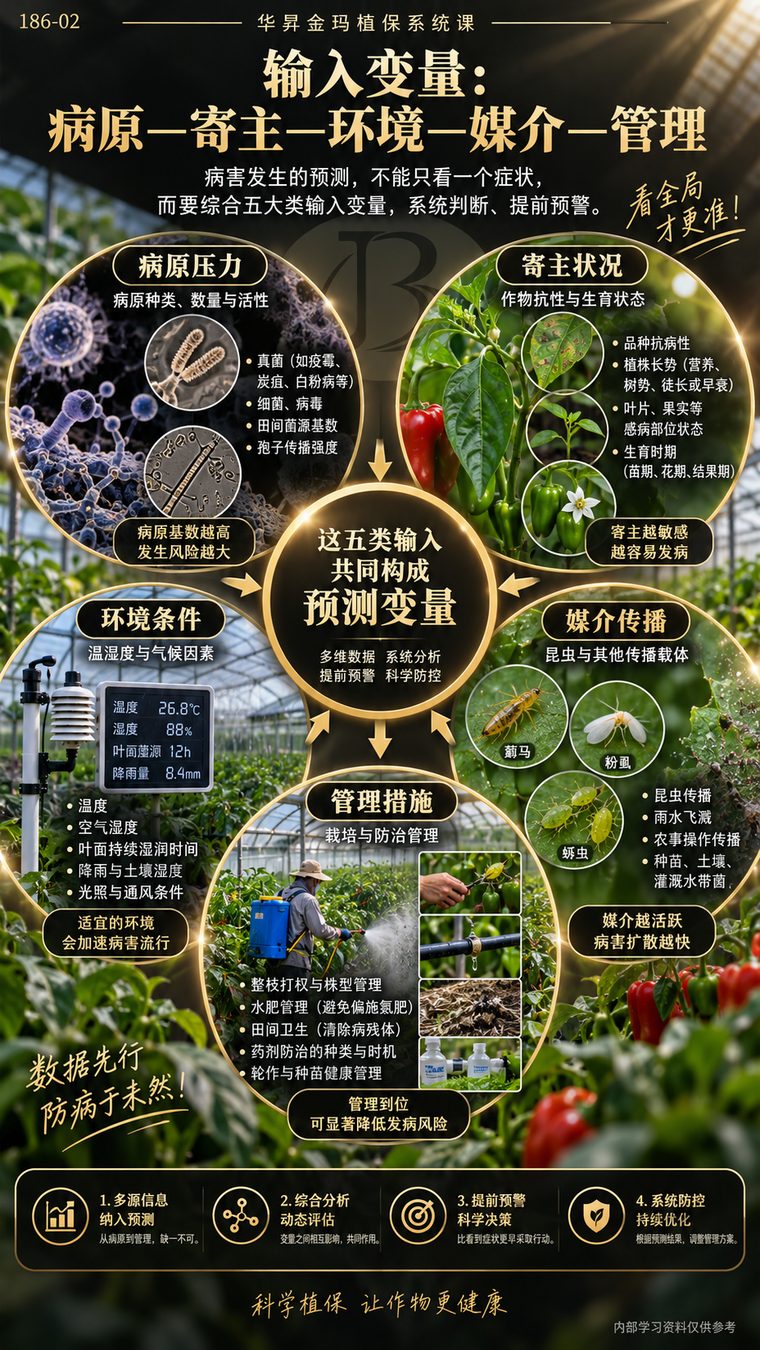 01/08 丨预测要先收齐五类输入变量
病原压力看种类、数量与活性——真菌(疫霉、炭疽、白粉等)、细菌与病毒,还要看田间菌源基数和孢子传播强度;寄主状况看品种抗病性、植株长势(营养、树势、徒长或早衰)、叶片果实等感病部位状态,以及处在苗期、花期还是结果期。病原基数越高、寄主越敏感,发生风险就越大,这两项是风险的两端。
环境条件提供温度、空气湿度、叶面持续湿润时间、降雨与土壤湿度、光照与通风,图上示意读数是26.8℃、湿度88%、叶面湿润12h、降雨8.4mm。媒介传播涵盖蓟马、粉虱、蚜虫等昆虫,也有雨水飞溅、农事操作、种苗与灌溉水带菌这些路径。管理措施则是整枝打杈与株型、水肥(避免偏施氮肥)、清除病残体的田间卫生、药剂种类与时机、轮作与种苗健康。华昇金玛植保系统课把这五类并列,是要说明预测是一张网,缺任何一类,判断都会偏。
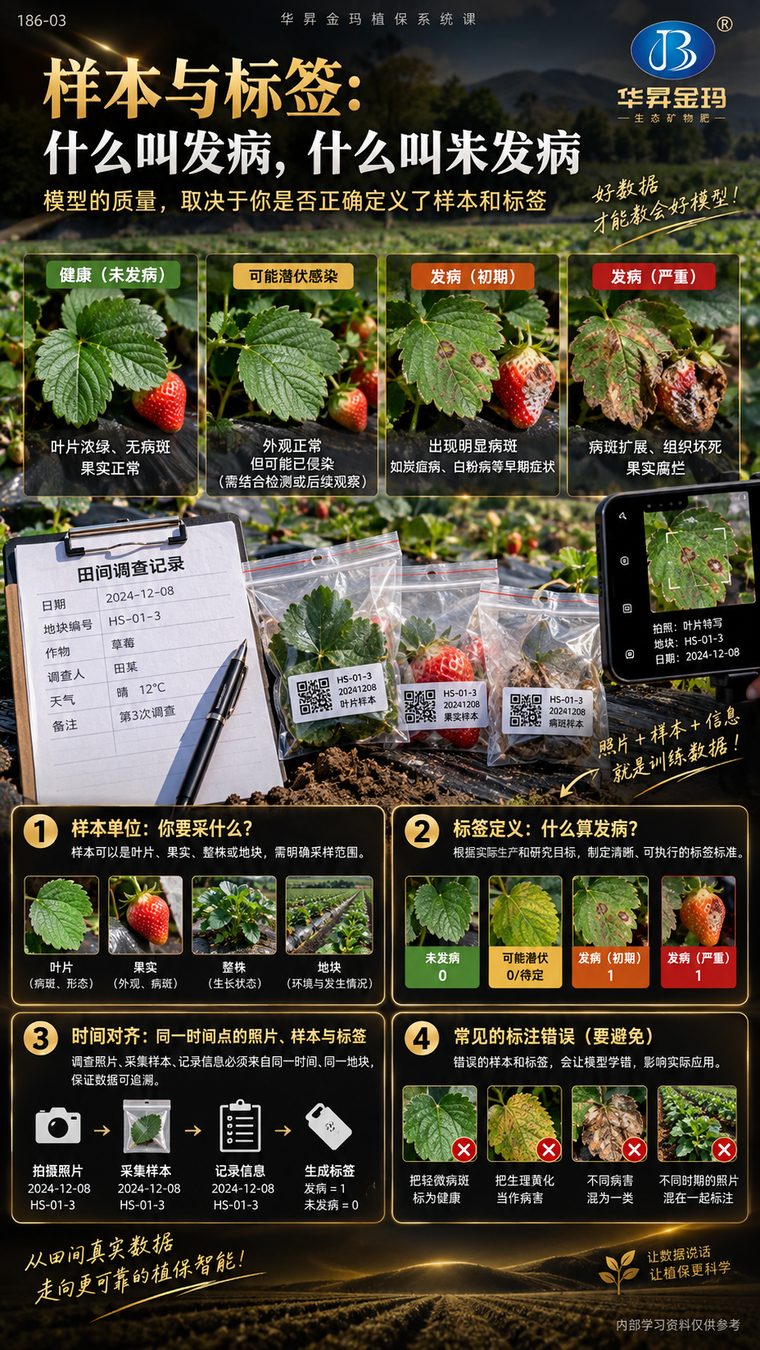 02/08 丨先定义清楚什么叫发病
样本和标签是所有病害识别与预测模型的地基。四个等级要分清:健康(未发病,叶片浓绿无病斑、果实正常)、可能潜伏感染(外观正常但可能已侵染,需结合检测或后续观察)、发病初期(出现明显病斑,如炭疽、白粉的早期症状)、发病严重(病斑扩展、组织坏死、果实腐烂)。健康与严重两头容易判,中间两档的判断往往含糊。
定义清楚之后要落成四步。样本单位先定采什么——叶片(病斑、形态)、果实(外观、病斑)、整株(生长状态)还是地块(环境与发生情况);标签定义按生产与研究目标给出可执行标准,未发病记0、可能潜伏记0或待定、发病(初期与严重)记1;时间对齐要求照片、样本与记录来自同一时间同一地块,像案例里地块HS-01-3、日期2024-12-08、作物草莓、调查人田某那样可追溯。常见的标注错误是把轻微病斑标为健康、把生理黄化当病害、不同病害混为一类、不同时期的照片混在一起标注,这些都会让模型学错。
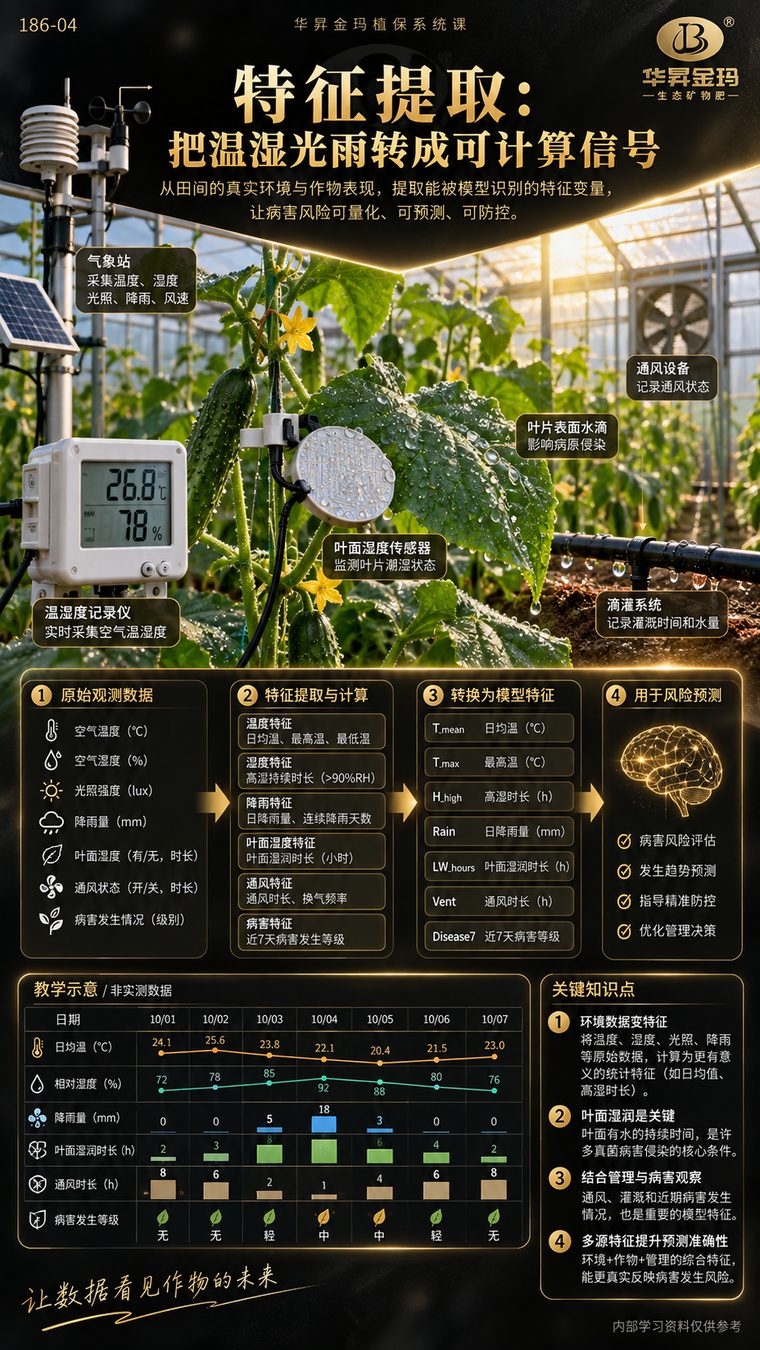 03/08 丨把温湿光雨变成模型特征
原始观测数据里躺着空气温度、空气湿度、光照强度、降雨量、叶面湿度(有/无及时长)、通风状态(开/关及时长)、病害发生级别这些记录。它们还不能直接进模型,要先做特征提取与计算:温度算成日均温、日内高温、日内低温,湿度算成高湿持续时长(>90%RH),降雨算成日降雨量与连续降雨天数,叶面湿度算成叶面湿润时长,通风算成通风时长与换气频率,病害算成近7天发生等级。
算完之后才转换成模型特征,也就是T.mean(日均温)、T.max(日内高温)、H.high(高湿时长)、Rain(日降雨量)、LW.hours(叶面湿润时长)、Vent(通风时长)、Disease7(近7天病害等级),再用于风险评估与趋势预测。教学表里10/01到10/07的示意数据显示,10/04那天湿度92%、降雨18mm、叶面湿润11小时、通风只有1小时,病害等级也升到“中”——叶面有水的持续时间是许多真菌病害侵染的核心条件,这条特征比单看温度更贴近风险。
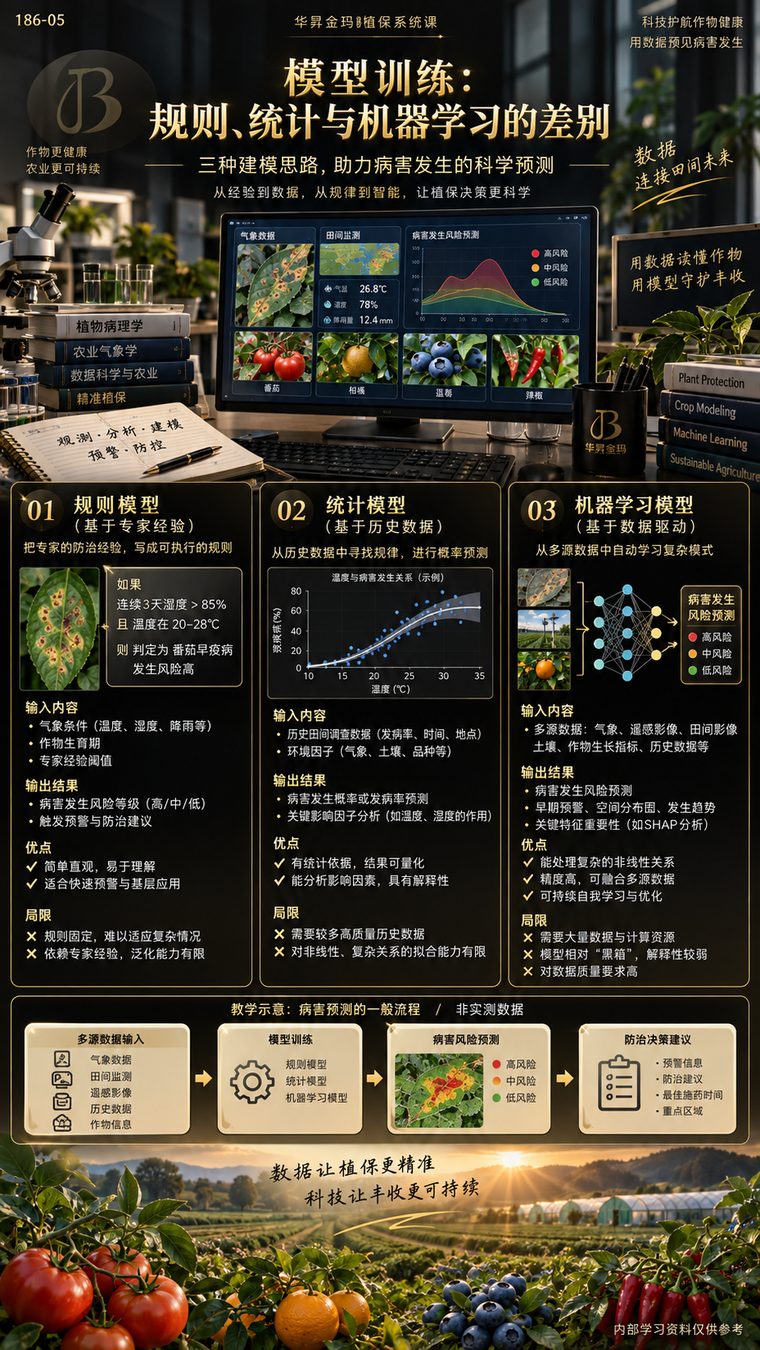 04/08 丨三种建模思路各有取舍
规则模型把专家经验写成可执行条件,例如“连续3天湿度>85%且温度在20–28℃,判定番茄早疫病发生风险高”。它的好处是简单直观、适合基层快速预警,局限是规则固定、难适应复杂情况,也比较依赖专家经验。统计模型从历史调查数据与环境因子里找规律做概率预测,能给出发病率预测并分析关键影响因子,但需要较多高质量历史数据,对非线性关系拟合有限。
机器学习模型从气象、遥感影像、田间影像、土壤、作物生长指标等多源数据里自动学习复杂模式,输出风险预测、早期预警、空间分布与趋势,还能给出特征重要性。它的短板是要大量数据与算力、可解释性偏弱、对数据质量要求高。三者面对的输入都是气象数据、田间监测、遥感影像、历史数据与作物信息,但走到风险等级和防治建议上的路径不同,选哪一种要看数据家底和实际需求。
 05/08 丨训练要好,泛化更要好
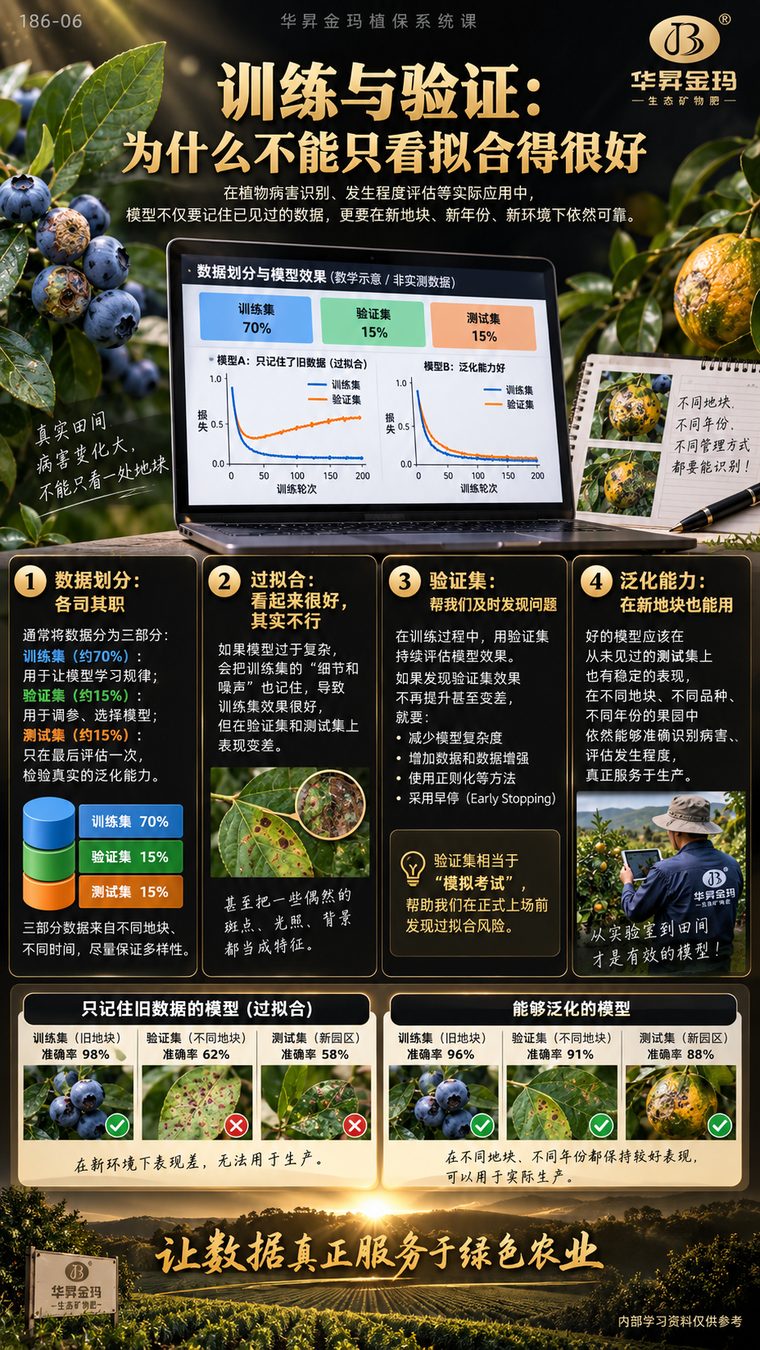
数据要分三份各司其职:训练集约70%用于学规律,验证集约15%用于调参和选模型,测试集约15%只在收尾评估一次、检验真实的泛化能力,三部分宜来自不同地块、不同时间以保证多样性。只看训练集效果就下结论,很容易踩过拟合——模型太复杂会把训练集的细节和噪声一起记住,甚至把偶然的斑点、光照、背景当成特征,结果训练集漂亮、验证集和测试集掉下来。
训练过程中要用验证集持续评估,它相当于一场模拟考试:一旦发现验证集效果不再提升甚至变差,就该减少模型复杂度、增加数据与数据增强、上正则化,或者用早停。图上两组对比很直观——过拟合模型在旧地块98%、到不同地块只有62%、新园区58%;泛化模型在旧地块96%、不同地块91%、新园区88%。真实田间病害变化大,不能只看一处地块,不同地块、不同年份、不同管理方式都能识别,模型才谈得上用于生产。
 06/08 丨评价模型要看漏报与提前量
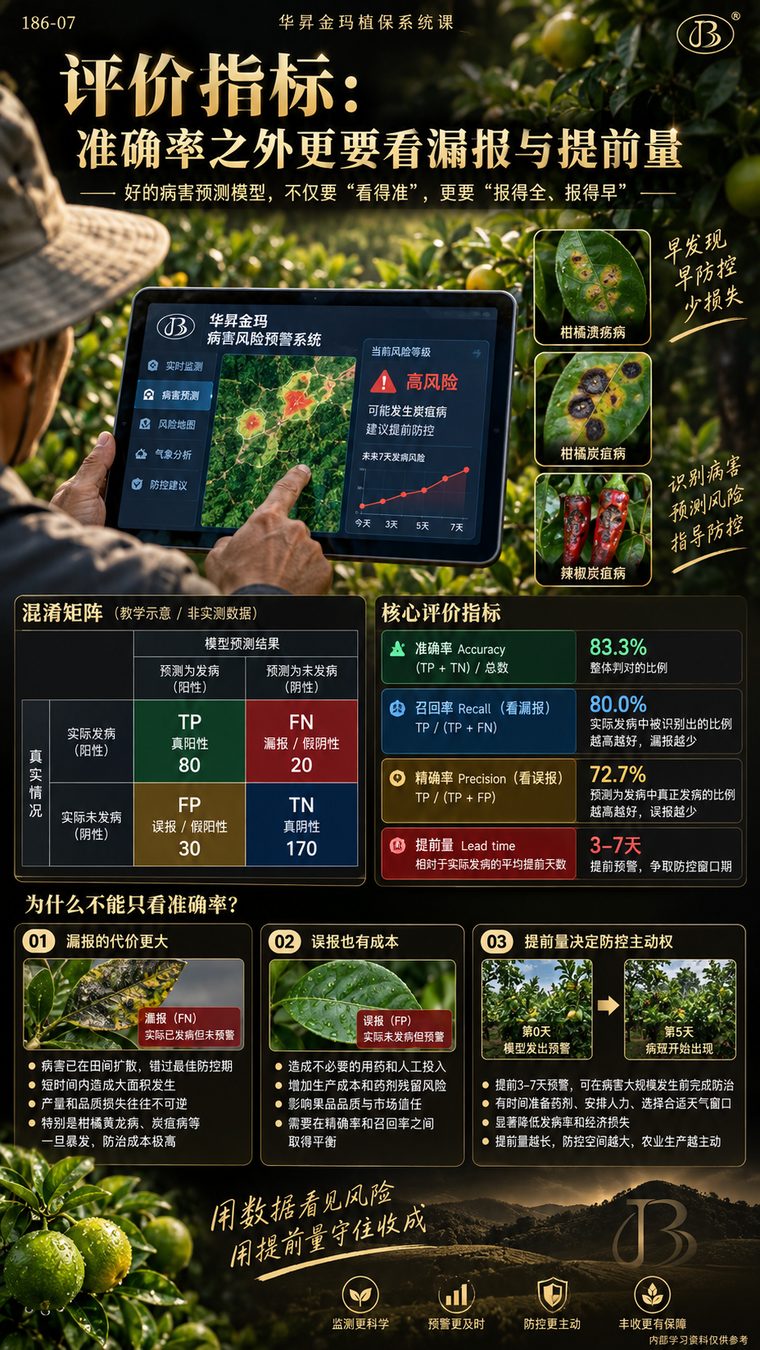
混淆矩阵把结果分四格:实际发病且预测发病是真正例80,实际发病却预测未发病是漏报20,实际未发病却预测发病是误报30,两边都判没中才是真阴性170。据此算出准确率83.3%(整体判对比例)、召回率80.0%(实际发病中被识别出的比例,看漏报)、精确率72.7%(预测发病中真正发病的比例,看误报),还有提前量3–7天。
为什么不能只看准确率?漏报的代价更大——病害已在田间扩散、错过防控窗口,短时间大面积发生,产量和品质损失往往不可逆,像炭疽病这类一旦暴发防治成本很高;误报也有成本,会造成不必要的用药与人工投入、抬高成本并带来药剂残留风险。提前量决定主动权,第0天发出预警、第5天病斑才开始出现,这3–7天正好用来备药、排人力、挑合适天气窗口。
 07/08 丨异地模型不能直接照搬
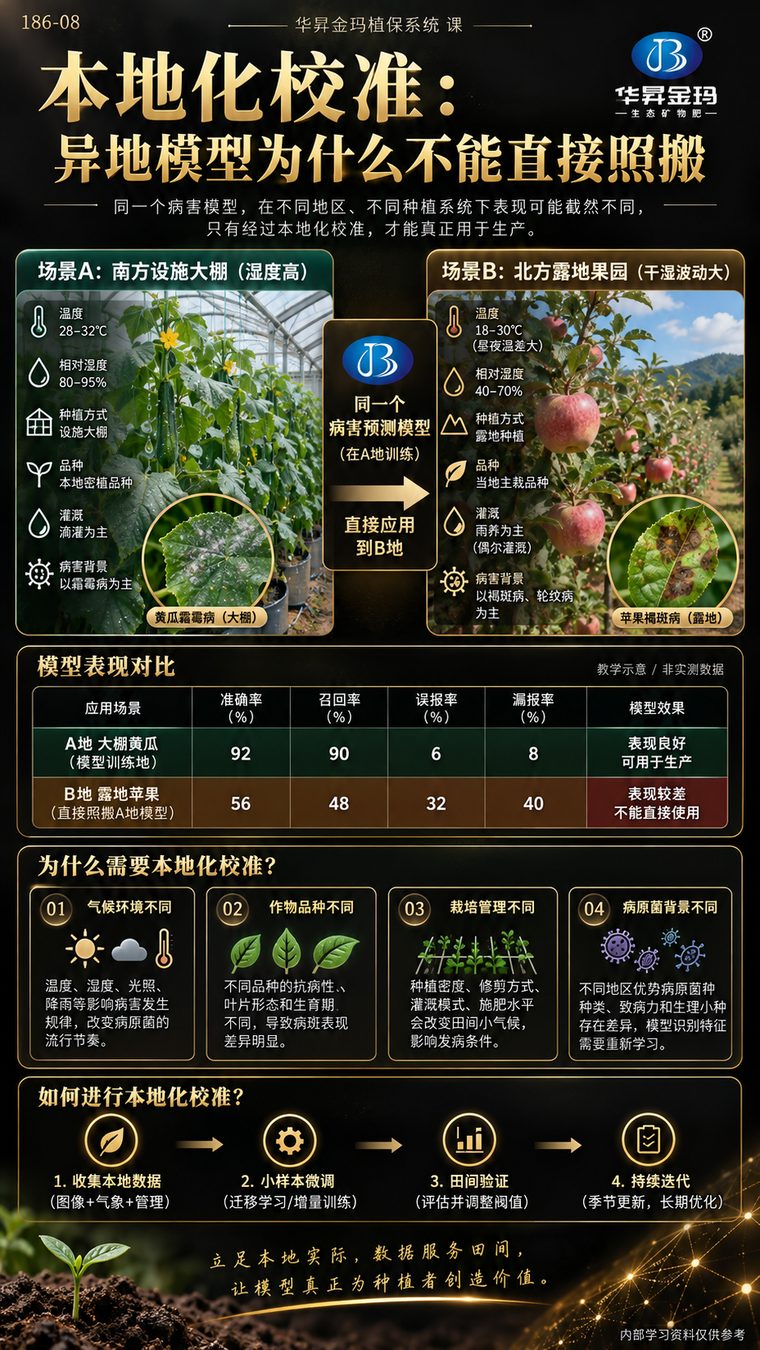
在A地训练好的模型直接用到B地,表现可能天差地别。南方设施大棚是28–32℃、相对湿度80–95%、滴灌为主、以霜霉病为主,模型在训练地拿到准确率92%、召回率90%;搬到北方露天果园——18–30℃、昼夜温差大、湿度40–70%、雨养为主、褐斑病与轮纹病为主——准确率掉到56%、召回率48%,误报率升到32%、漏报率40%,已经不能直接使用。
差异来自四件事:气候环境不同会改变病原流行节奏;作物品种的抗病性、叶片形态和生育期不同,病斑表现差异明显;栽培管理的密度、修剪、灌溉与施肥改变田间小气候;病原菌的种类、致病力与生理小种存在地区差异,识别特征得重新学。校准的路径是收集本地数据(图像+气象+管理)、做小样本微调(迁移学习或增量训练)、田间验证并调整阈值、再随季节持续迭代。立足本地实际,数据才能服务田间。
 08/08 丨从监测到再训练的闭环
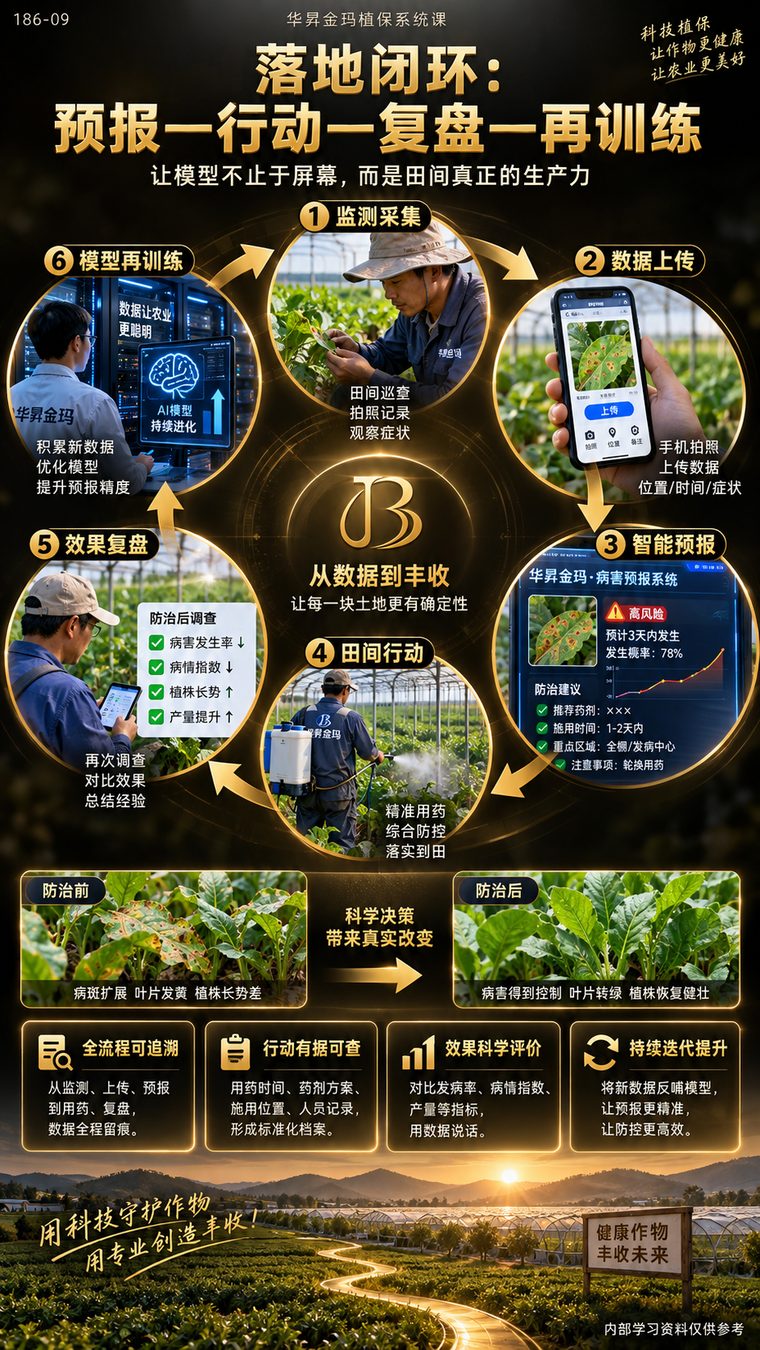
闭环是六步一环:①监测采集(田间巡查、拍照记录、观察症状)→②数据上传(手机拍照、位置时间症状一并记录)→③智能预报(如预计3天内发生、发生概率78%,给出施用时间、重点区域与注意事项)→④田间行动(精准用药、综合防控、落实到田)→⑤效果复盘(防治后再次调查,对比病害发生率、病情指数与植株长势)→⑥模型再训练(积累新数据、优化模型、提升预报精度),再回到监测。
华昇金玛植保系统课提醒,要让预报带出动作,生物与化学手段得排进档案。病害预防场景里,可以在定植前后用枯草芽孢杆菌(高活芽孢,灌根/基施500g/亩·次)打底,或在大棚冲施三结义微生物菌剂(1–2L/亩·次,避开强光高温);大田飞防则用美添健·禾(飞防/叶面800–1000倍,按亩用药液量配)。图上把全流程可追溯、行动有据可查、效果科学评价、持续迭代提升四项特性并列,说的是同一件事:把每次预报变成下一次更准的基础。
实际生产管理请结合当地土壤检测、气候条件与作物长势调整。