叶面有水、水停留了多久,是很多真菌病害能不能侵染的关键变量。可“叶湿时间”看不见摸不着,只能靠传感器模拟叶片表面把它量出来。不同作物、不同病原为什么配不同模型,冠层传感器该架在哪、读数怎么校准,预警发出后又怎么回田间核对,都要一项项落实。误报和漏报的代价并不一样,模型换到新地区也要按本地条件重新校准。把叶面的湿润时长变成可比较的数字,预警才有讨论的共同基础,也给复查留下依据。
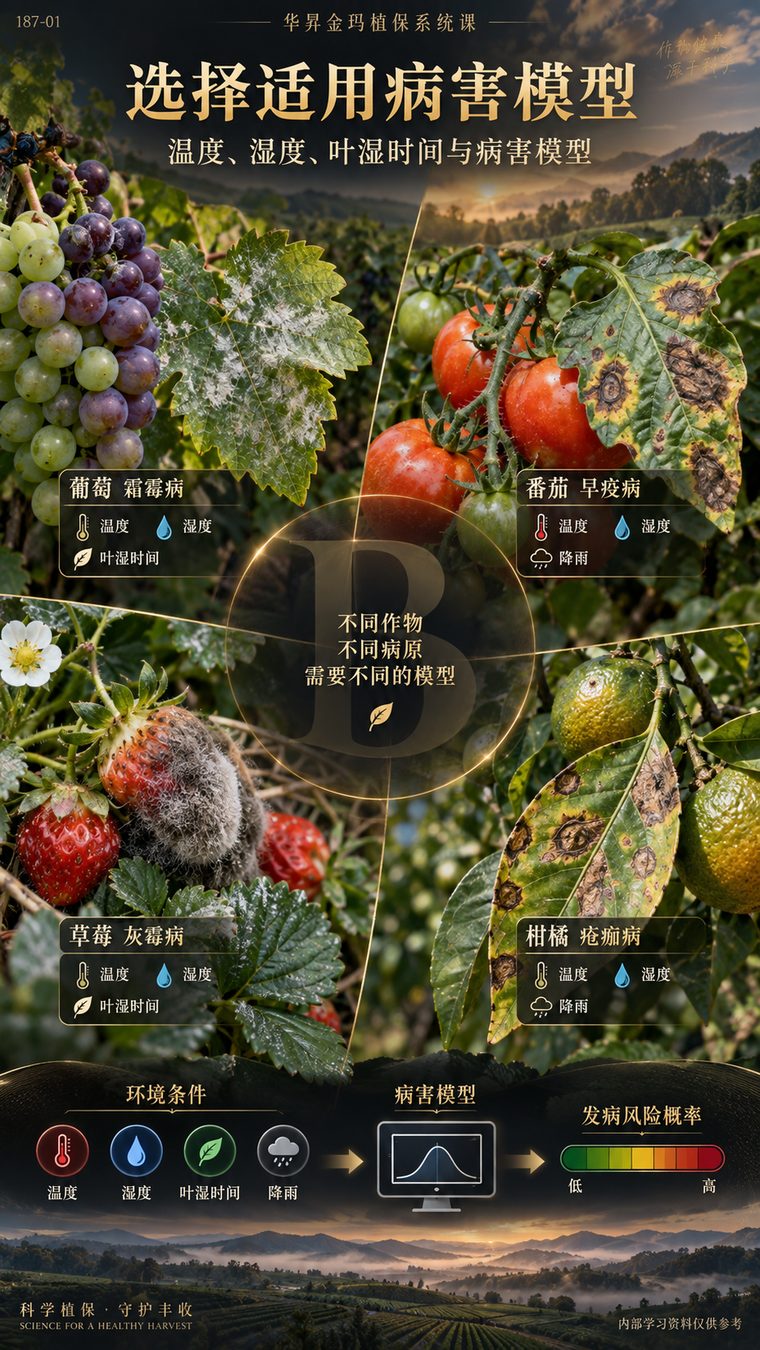 01/08 丨不同作物病害需要不同的模型
图上的四宫格摆了四种典型对象——葡萄霜霉病、番茄早疫病、草莓灰霉病、柑橘疮痂病,每一种后面都跟着它尤其看重的环境因子。葡萄霜霉病盯温度、湿度和叶湿时间,番茄早疫病盯温度、湿度和降雨,草莓灰霉病盯温度、湿度和叶湿时间,柑橘疮痂病盯温度、湿度和降雨。同样三个大类变量,不同病原的权重并不一样:靠叶面水膜侵染的,叶湿时间权重就高;靠雨水飞溅传播的,降雨就更关键。
图底给出三段推进关系——环境条件(温度、湿度、叶湿时间、降雨)进入病害模型,模型再输出发病风险概率,从绿色低风险走到红色高风险。这说明模型不是拿一个通用公式套所有作物,而是要先选对适用对象。落到生产上,先明确田里主要防哪一种病,再决定监测哪些因子、用哪个模型,才不会拿葡萄的模型去套番茄。
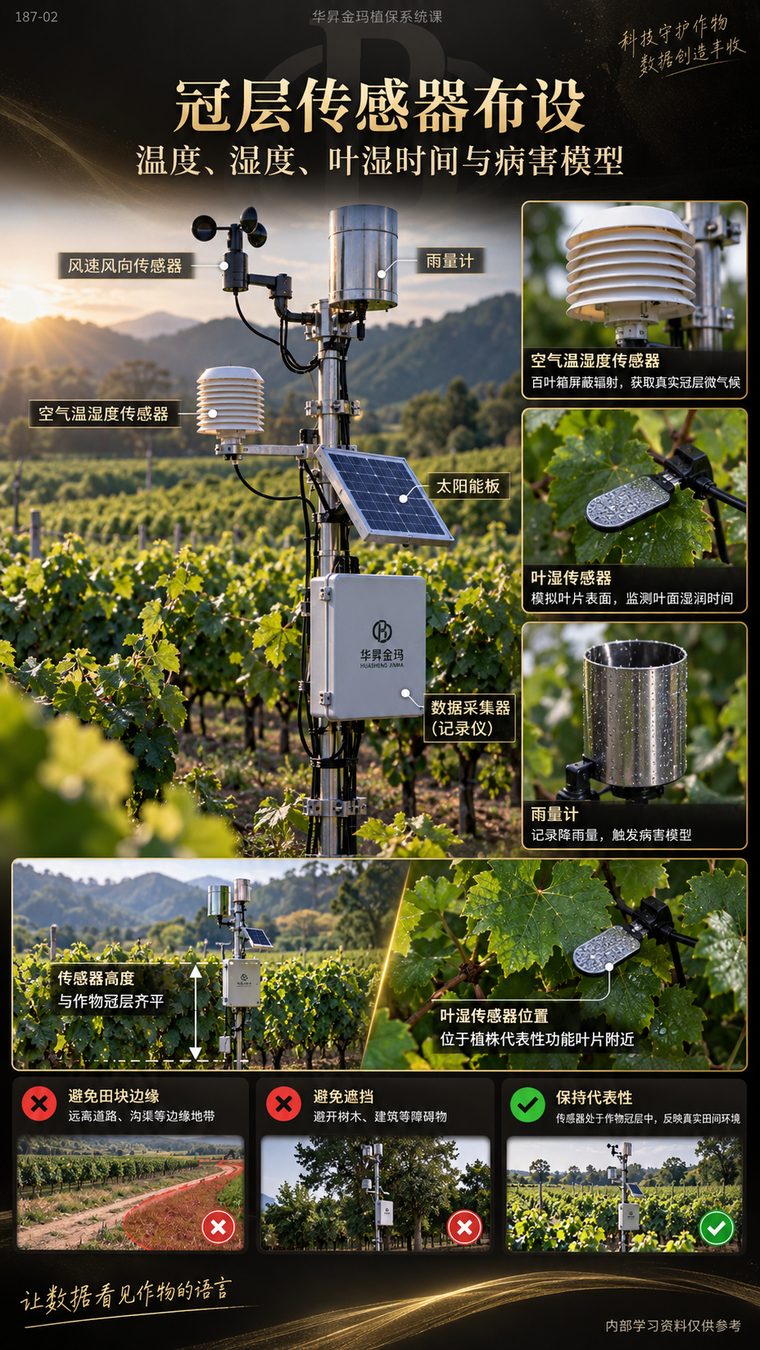 02/08 丨冠层传感器布设位置与原则
这张图把一套冠层监测站的构成拆开:自上而下有风速风向仪、雨量计、空气温湿度传感器(百叶箱式)、太阳能板和数据采集器,采集器箱体上还印着华昇金玛的标识。三个取样部件各管一件事——百叶箱屏蔽辐射、取到真实的冠层微气候;夹在叶片上的叶湿传感器模拟叶片表面、测叶面湿润时间;雨量计记录降雨量、用来触发模型。安装上有一条硬要求:传感器高度要与作物冠层齐平,叶湿传感器要放在代表性功能叶片附近。
图底的三条布设原则容易被忽略:避开田块边缘,远离道路、沟渠这些边缘地带;避免遮挡,避开树木和建筑;保持代表性,传感器要处在作物冠层中。原因很直接——边缘位置的小气候和冠层中心差得远,被遮挡的读数会系统性偏低,采到“看着规整其实不代表田间”的数据,后面的风险判断就会跟着偏。布点是整套监测的地基,这一步做粗了,再好的模型也救不回来。
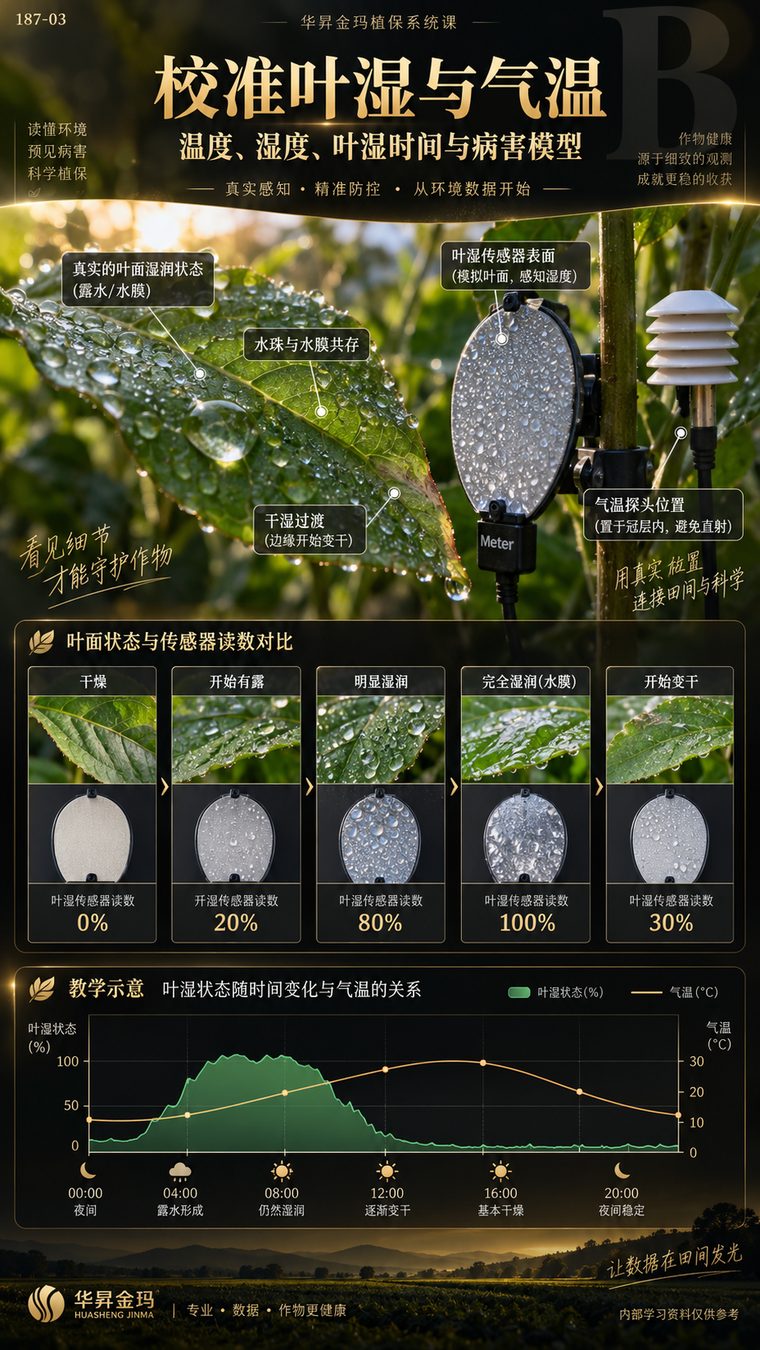 03/08 丨叶湿与气温读数怎么校准
图中央是一组真实对比:带水珠的叶片、夹在叶片上的叶湿传感器,以及置于冠层内的气温探头,让“真实叶面”和“传感器读数”能对照着看。标注框把叶面状态拆成干燥、开始有露、明显湿润、完全湿润(水膜)、开始变干几个阶段,右边给出对应读数,从0%一路升到满值,再回落到30%。也就是说,传感器读的是一层模拟表面,必须用实际的叶面状态去校准,读数才有意义。
下方那张双轴图把两者随时间的变化摊开:左轴是叶湿状态,右轴是气温,横轴从00:00到20:00。夜间叶湿接近0、气温约10℃;04:00前后露水形成,叶湿快速升到峰值;08:00仍处湿润高位,气温继续抬升;12:00叶湿骤降、气温接近峰值;16:00叶面基本干燥、气温升到峰值;入夜后又回到低位。看懂这条曲线,才能知道风险窗口出现在哪几个小时——不是有露就危险,而是看湿润持续了多久、当时温度落在什么区间。
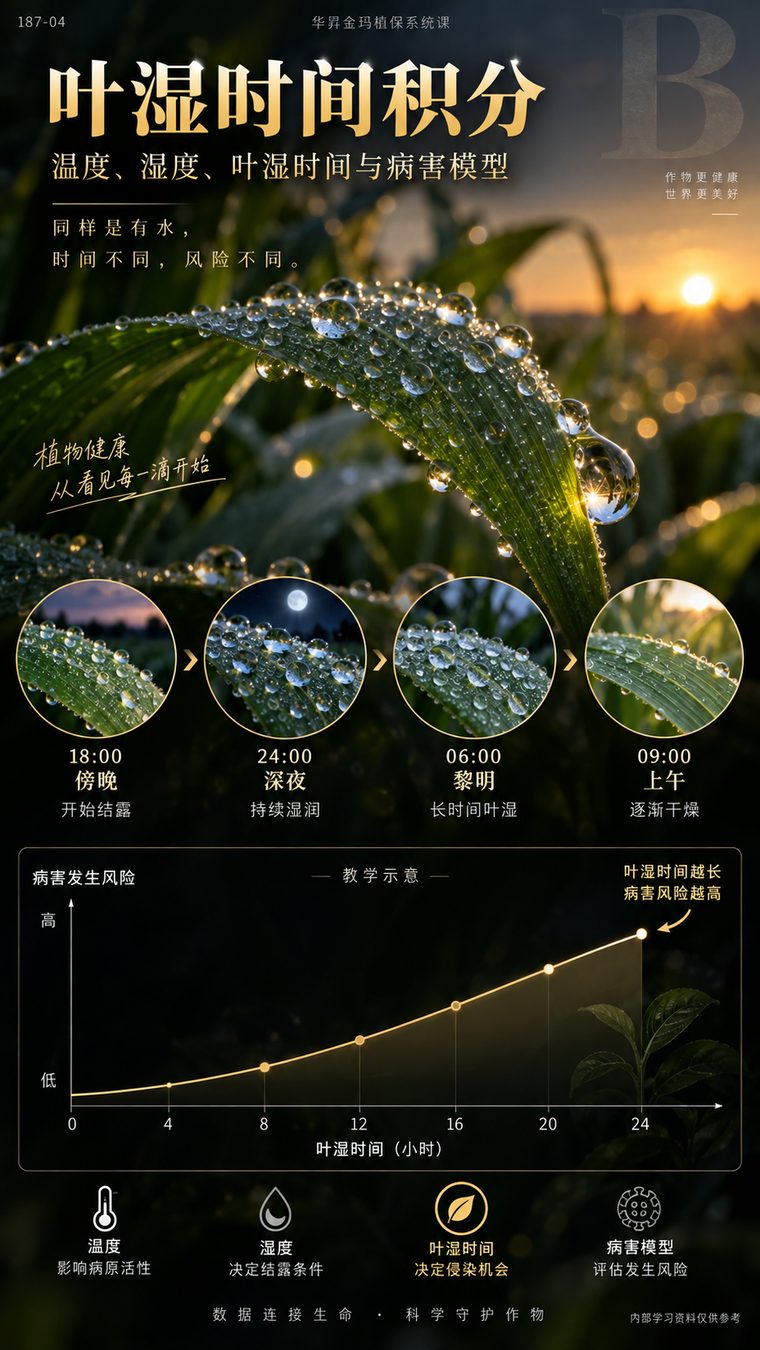 04/08 丨有水还不够,时间才是关键
核心其实很直白:同样是有水,时间不同,风险不同。正午一段骤雨,叶面打湿又很快晒干,病原还没站住脚;而傍晚结露、整夜湿润、直到次日上午才慢慢干掉,叶面连续有水的时段就长得多。图上用四个时间点把一段典型的夜间湿润画出来:18:00傍晚开始结露,24:00深夜持续湿润,06:00黎明长时间叶湿,09:00上午逐渐干燥。夜间气温低、蒸发慢,水膜能挂住整晚,这正是侵染更容易发生的时段。
下方的折线图把结论量化:横轴是叶湿时间(小时),纵轴是病害发生风险,曲线随时间单调上升,到24小时处到顶,箭头指向“叶湿时间越长,病害风险越高”。图底还标出四个因子的分工——温度影响病原活性,湿度决定结露条件,叶湿时间决定侵染机会,病害模型据此评估发生风险。所以“叶湿时间积分”不是把几小时的湿度简单平均,而是把叶面持续有水的时长累加起来,它才是判断侵染机会的那个量。
 05/08 丨模型预警后要回田间验证
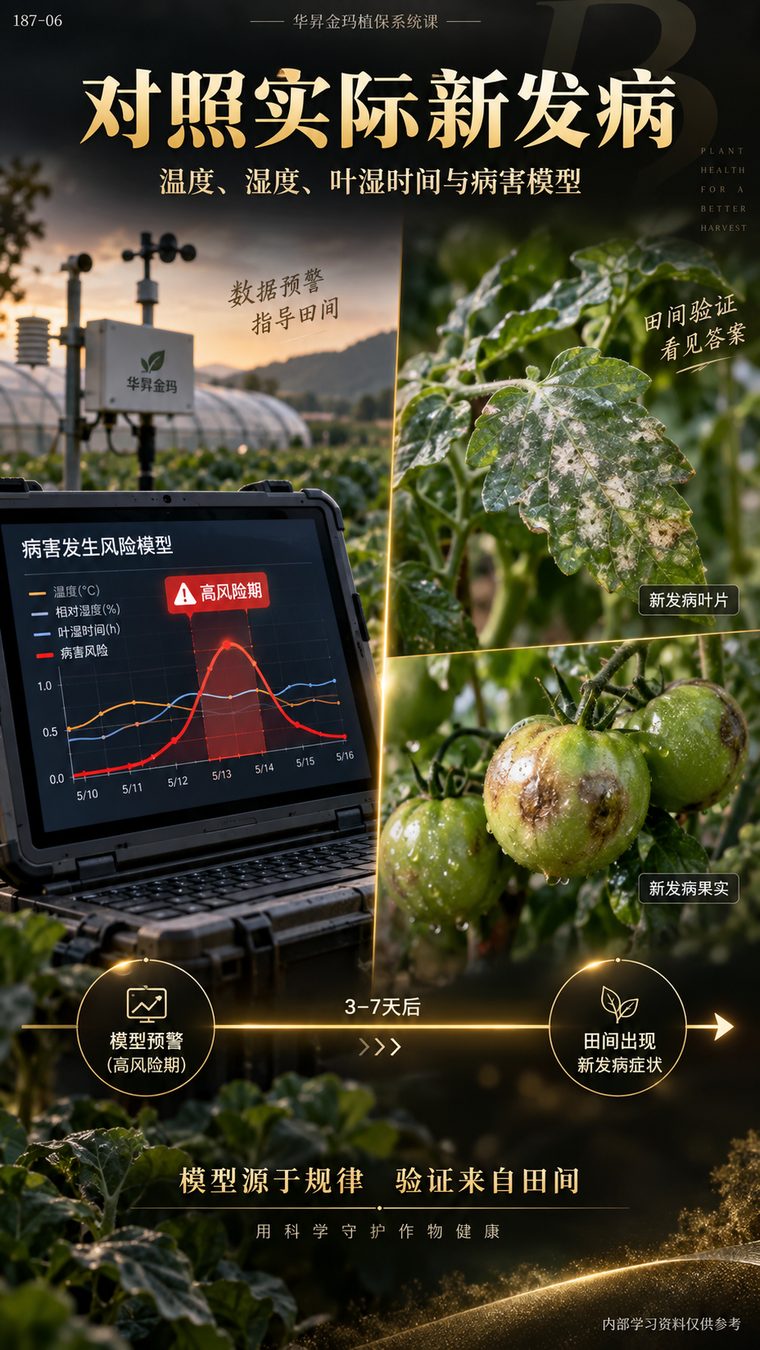
再看“模型”和“田间”的并排对照。左边是黄昏里的监测站和一台黑色加固电脑,屏幕上跑着病害发生风险模型,四行图例分别是温度、相对湿度、叶湿时间和病害风险,横轴从5/10到5/16,红色风险曲线在5/13前后冲出一个尖峰,标注“高风险期”。右边是两张微距实拍,一张是布满白色霉斑、已经黄化坏死的番茄叶片,标着“新发病叶片”,一张是青色番茄果实上的褐色水渍状凹斑,标着“新发病果实”。
把两边接起来的是底部的时间轴:左端“模型预警(高风险期)”——中间一段“3-7天后”——右端“田间出现新发病症状”。它说的是模型的价值不只在屏幕上的那条曲线,而在它和真实病情能不能对上。预警亮起来之后,正确的动作是下田去查、去拍、去记,看预警的时段和位置是不是真有新病斑冒出来。华昇金玛植保系统课提醒,核对上了模型可信度才往上走;对不上,就得回过头找是哪一环的输入出了问题。
 06/08 丨误报与漏报各有什么代价
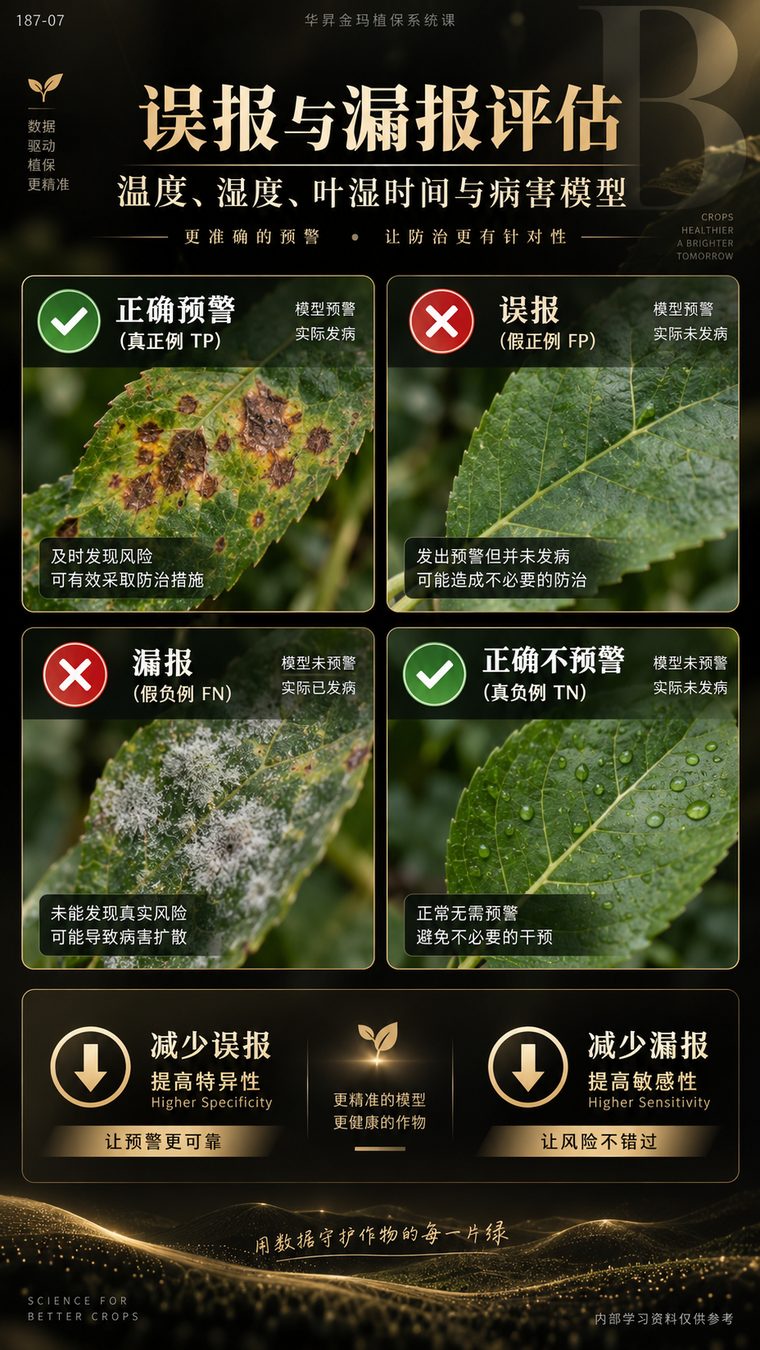
这张图用2×2四格把预警结果分清楚。正确预警(真正例)是发了预警、田里也确实发病,说明能及时采取措施;误报(假正例)是发了预警,实际是健康无病的叶片,代价是可能造成不必要的防治;漏报(假负例)是没预警、田里却长了病,图上对应的就是覆着白色霉层的叶片,代价是病害可能扩散;正确不预警(真负例)是没预警也确实没病,避免了不必要的干预。
四格的价值在于把“准不准”拆成两个方向:减少误报是提高特异性,让预警更可靠;减少漏报是提高敏感性,让风险不错过。图底部把这两个方向并列,中间落在“更精准的模型、更健康的作物”上。两边的优先级并不相同——漏报让病害在田间继续扩散,防控窗口被错过之后往往补不回来;误报则表现为多打的药、多花的人工。所以调模型的阈值时,得先想清楚这块地更怕哪一种代价。
 07/08 丨同一模型要按本地条件校准
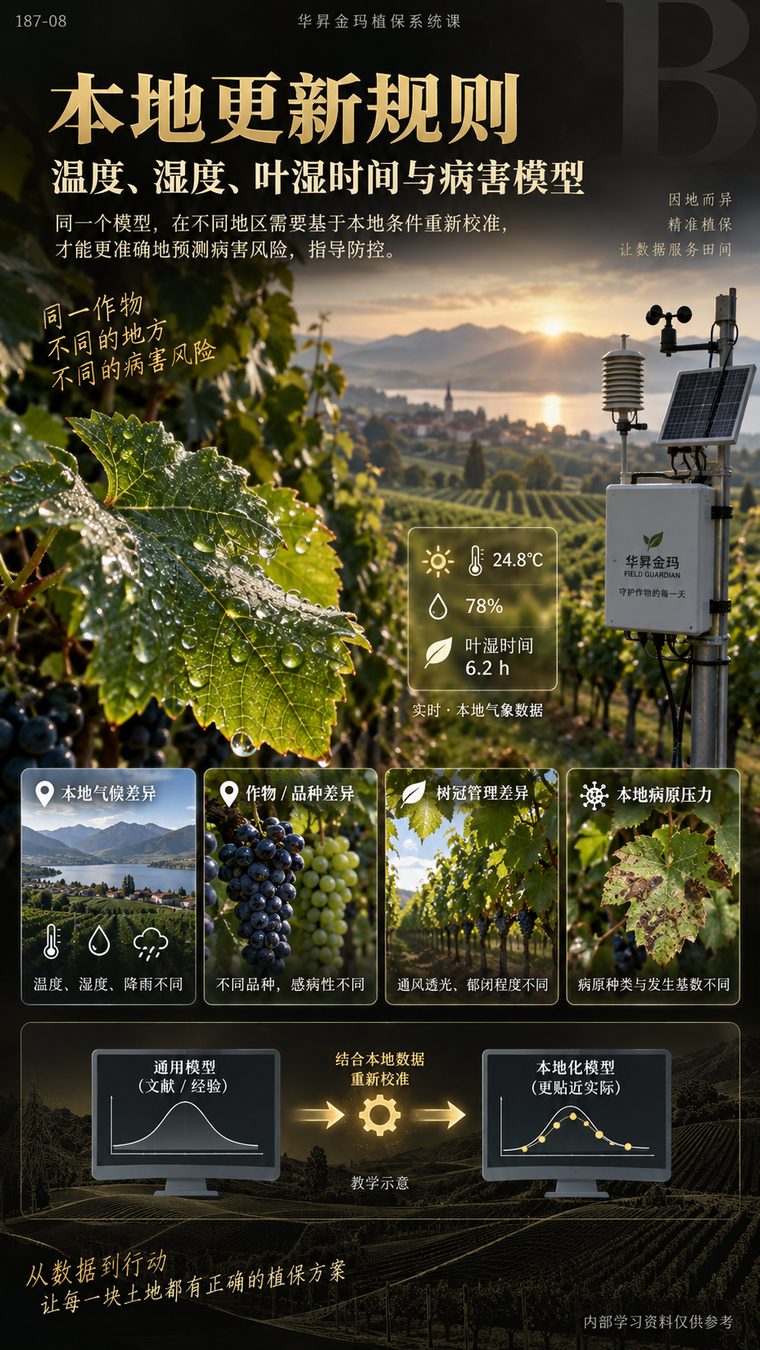
这一页的说明很明确:同一个模型,在不同地区需要基于本地条件重新校准,才能更准确地预测病害风险。图上给出的本地实时气象数据是24.8℃、78%、叶湿时间6.2小时,这些就是校准的输入。为什么非校准不可,下面四张卡说得很清楚——本地气候差异(温度、湿度、降雨不同)、作物与品种差异(不同品种感病性不同)、树冠管理差异(通风透光、郁闭程度不同)、本地病原压力(病原种类与发生基数不同),每一项都会改变风险的落点。
底部用一组简单的流程把做法画出来:左边是文献和经验攒起来的通用模型,中间经过“结合本地数据、重新校准”,右边才是本地化模型。落到果园和大棚,校准不是推倒重来,而是把本地的温度、湿度、叶湿时间和田间发病记录喂回去,微调模型参数,再在田里验证阈值合不合适。病害预防场景里,可以在定植前后用枯草芽孢杆菌(高活芽孢,灌根/基施500g/亩·次)打底,或冲施三结义微生物菌剂(1–2L/亩·次,避开强光高温),让根际环境和模型的判断互相印证。
 08/08 丨模型适用边界要写在前面
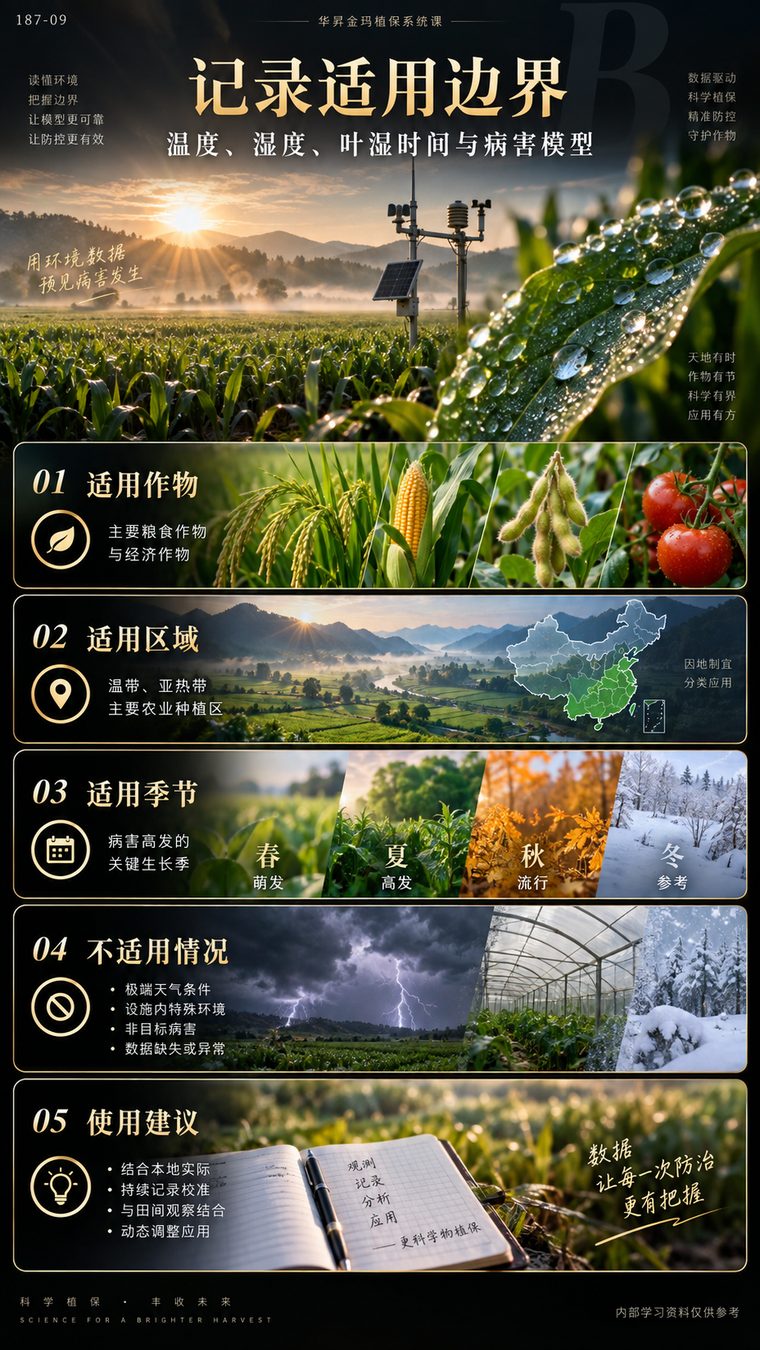
关于这套模型能用在哪些地方,图上列了五条。适用作物主要是粮食作物与经济作物;适用区域是温带、亚热带的主要农业种植区;适用季节是病害高发的关键生长季。更关键的是另外两条——不适用情况列了极端天气条件、设施内特殊环境、非目标病害、数据缺失或异常,其中设施内的小气候和大田差得远,套用露地模型容易失准;使用建议则强调结合本地实际、持续记录校准、与田间观察结合、动态调整应用。
把边界写下来这件事,看起来是收尾,其实是让模型能用对的前提。数据缺失或传感器异常期间的推算结果要打折看,非目标病害不能拿这套模型硬套,极端天气下模型给的概率只作参考。华昇金玛植保系统课把这些边界明明白白列出,是为了让使用者知道什么时候该信、什么时候该回田间亲眼核对,而不是让一个数字替自己下决定。
实际生产管理请结合当地土壤检测、气候条件与作物长势调整。